Pular para o conteúdo
Todos os projetos

Engenharia de IA · Python · AWS

Prumo

A taxa real de acerto de uma IA em produção: poucos rótulos humanos corrigem o viés do juiz LLM, e o prompt volta sozinho quando a qualidade cai.

Cliente
Projeto pessoal open source
Cargo
Engenheiro de Software — projeto independente
Ano
2026
Tecnologias
  • Python
  • FastAPI
  • Amazon Bedrock
  • AWS Lambda
  • AWS CDK
  • Step Functions
  • DynamoDB
  • AppConfig
  • CloudWatch
  • Pydantic
  • NumPy
  • pytest
  • GitHub Actions

Contexto

Serviço open source em Python 3.12 que mede a taxa real de acerto de uma IA em produção. A IA (Amazon Nova Lite no Bedrock) classifica leads em QUENTE, MORNO ou FRIO, um juiz LLM confere 100% das decisões, uma amostra aleatória vai para revisão humana e a estatística corrige o viés do juiz. Todos os dados são sintéticos. O projeto continua o Easy Control, em que a IA pré-qualifica os leads e o CEO revisa cada QUENTE ou MORNO antes do primeiro contato, porque o volume ainda permite.

Desafio

Com um volume 50 vezes maior, revisar tudo deixa de ser possível. Confiar só no juiz LLM também não basta: ele erra de forma sistemática, e quando um prompt novo faz a IA errar mais, nada quebra, nenhum alerta dispara e a nota do juiz quase não se mexe. O desafio era manter a automação sob controle com poucos rótulos humanos, saber a taxa real com uma margem de erro que continue honesta mesmo consultada a cada hora, e reverter o prompt sem depender de alguém perceber.

Resultados

simulações em que a queda de 92% para 76% foi detectada e revertida, enquanto o juiz seguia em cerca de 91% (benchmark prumo bench)
10/10
rollbacks indevidos da v3, a versão que melhora a IA, em todas as configurações do benchmark
0/10
de acerto real da Nova Lite no teste na AWS com 30 leads sintéticos, contra 70% aprovados pelo juiz Nova Pro, que deixou passar 4 classificações erradas
60%
testes automatizados: 205 no app, com 94% de cobertura, e 56 na infraestrutura em CDK
261

Principais entregas

  1. 01Implementei em Python puro, com os módulos math e statistics da biblioteca padrão, a Prediction-Powered Inference (PPI e PPI++), que usa uma amostra aleatória de rótulos humanos para descontar o viés do juiz LLM e entrega a taxa real de acerto com faixa de confiança, além de uma sequência de confiança válida a qualquer momento (Waudby-Smith et al., 2024) para leituras de hora em hora.
  2. 02Arquitetei na AWS, com CDK em Python, o fluxo completo: API em FastAPI na Lambda (via Mangum), classificador e juiz no Bedrock pela Converse API com tool use forçado, DynamoDB single-table com contadores atômicos e TTL de 180 dias, e revisão humana no Step Functions com waitForTaskToken.
  3. 03Automatizei o rollback do prompt: o estimador horário publica a métrica em EMF no CloudWatch, e o alarme de 2 leituras seguidas abaixo da meta (SLO de 85%) aciona, pelo EventBridge, uma Lambda que reverte a versão no AppConfig com compare-and-swap, com o próprio estimador como rede de segurança.
  4. 04Desenvolvi o painel web em FastAPI com um simulador sem custo de AWS e o benchmark prumo bench, que reproduz uma versão de prompt que derruba a IA de 92% para 76% enquanto o juiz segue em cerca de 91%, comparando métodos e volumes de rótulos por hora.
  5. 05Criei 261 testes automatizados (205 no app, com 94% de cobertura, e 56 na infraestrutura), incluindo propriedades com Hypothesis, simulações de Monte Carlo em NumPy que validam a cobertura do intervalo e adaptadores AWS testados com Stubber e moto, sob mypy strict, ruff e CI no GitHub Actions.
  6. 06Protegi a operação com token administrativo gerado pelo Secrets Manager e lido no cold start, deploy pelo GitHub Actions com OIDC sem chave de acesso guardada, alarmes no SNS com fila SQS de mensagens mortas para o rollback e dados exclusivamente sintéticos.
  1. O juiz e a taxa real

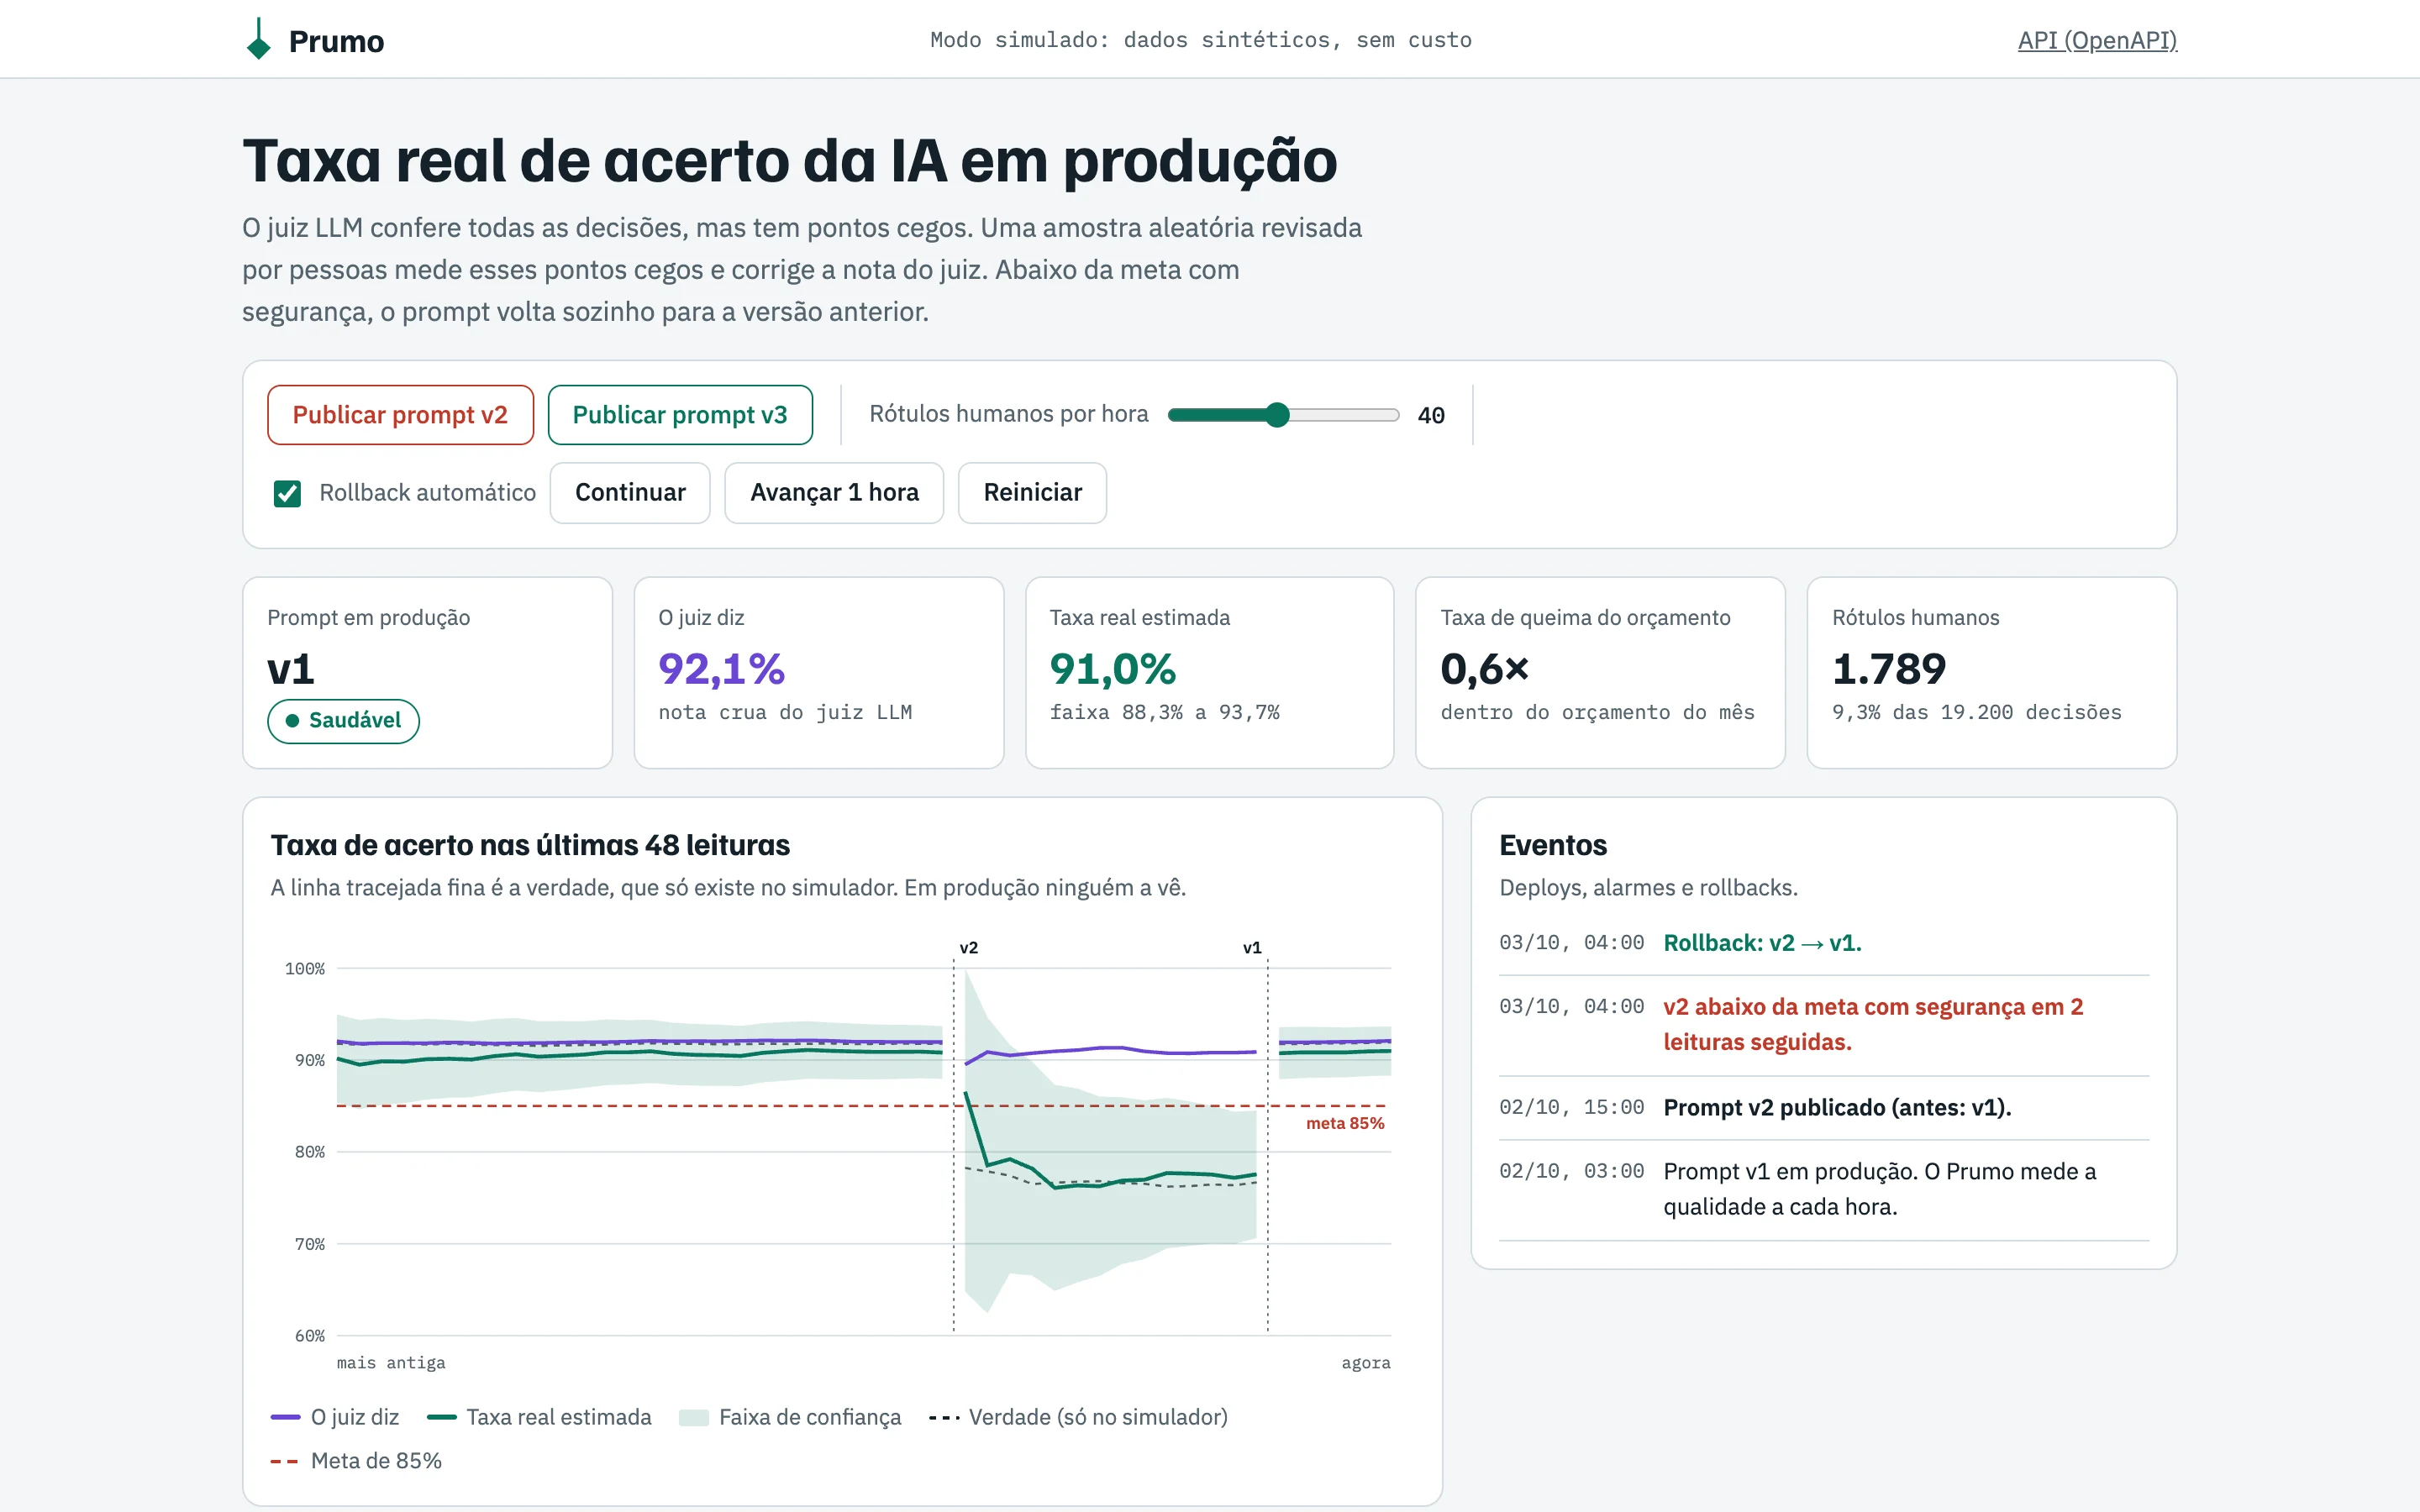
    Depois do incidente, a nota do juiz quase não se mexe, a taxa real estimada cai com a v2 e o prompt volta sozinho para a v1. O painel é do simulador, com dados fictícios.

    Painel do Prumo no tema claro, no modo simulado, depois do incidente: o prompt v1 de volta em produção com o status Saudável, o juiz dizendo 92,1%, a taxa real estimada de 91,0% com faixa de 88,3% a 93,7%, taxa de queima do orçamento de 0,6× e 1.789 rótulos humanos, 9,3% de 19.200 decisões; o gráfico das últimas 48 leituras, em que a nota do juiz fica quase plana perto de 91% enquanto a taxa real estimada cai com a faixa entre os marcadores v2 e v1, abaixo da meta tracejada de 85%, e volta ao patamar anterior depois do v1; e os eventos: v1 em produção, publicação da v2, v2 abaixo da meta com segurança em 2 leituras seguidas e rollback de v2 para v1.
    Painel do Prumo no tema claro, no modo simulado, depois do incidente: o prompt v1 de volta em produção com o status Saudável, o juiz dizendo 92,1%, a taxa real estimada de 91,0% com faixa de 88,3% a 93,7%, taxa de queima do orçamento de 0,6× e 1.789 rótulos humanos, 9,3% de 19.200 decisões; o gráfico das últimas 48 leituras, em que a nota do juiz fica quase plana perto de 91% enquanto a taxa real estimada cai com a faixa entre os marcadores v2 e v1, abaixo da meta tracejada de 85%, e volta ao patamar anterior depois do v1; e os eventos: v1 em produção, publicação da v2, v2 abaixo da meta com segurança em 2 leituras seguidas e rollback de v2 para v1.
  2. O incidente

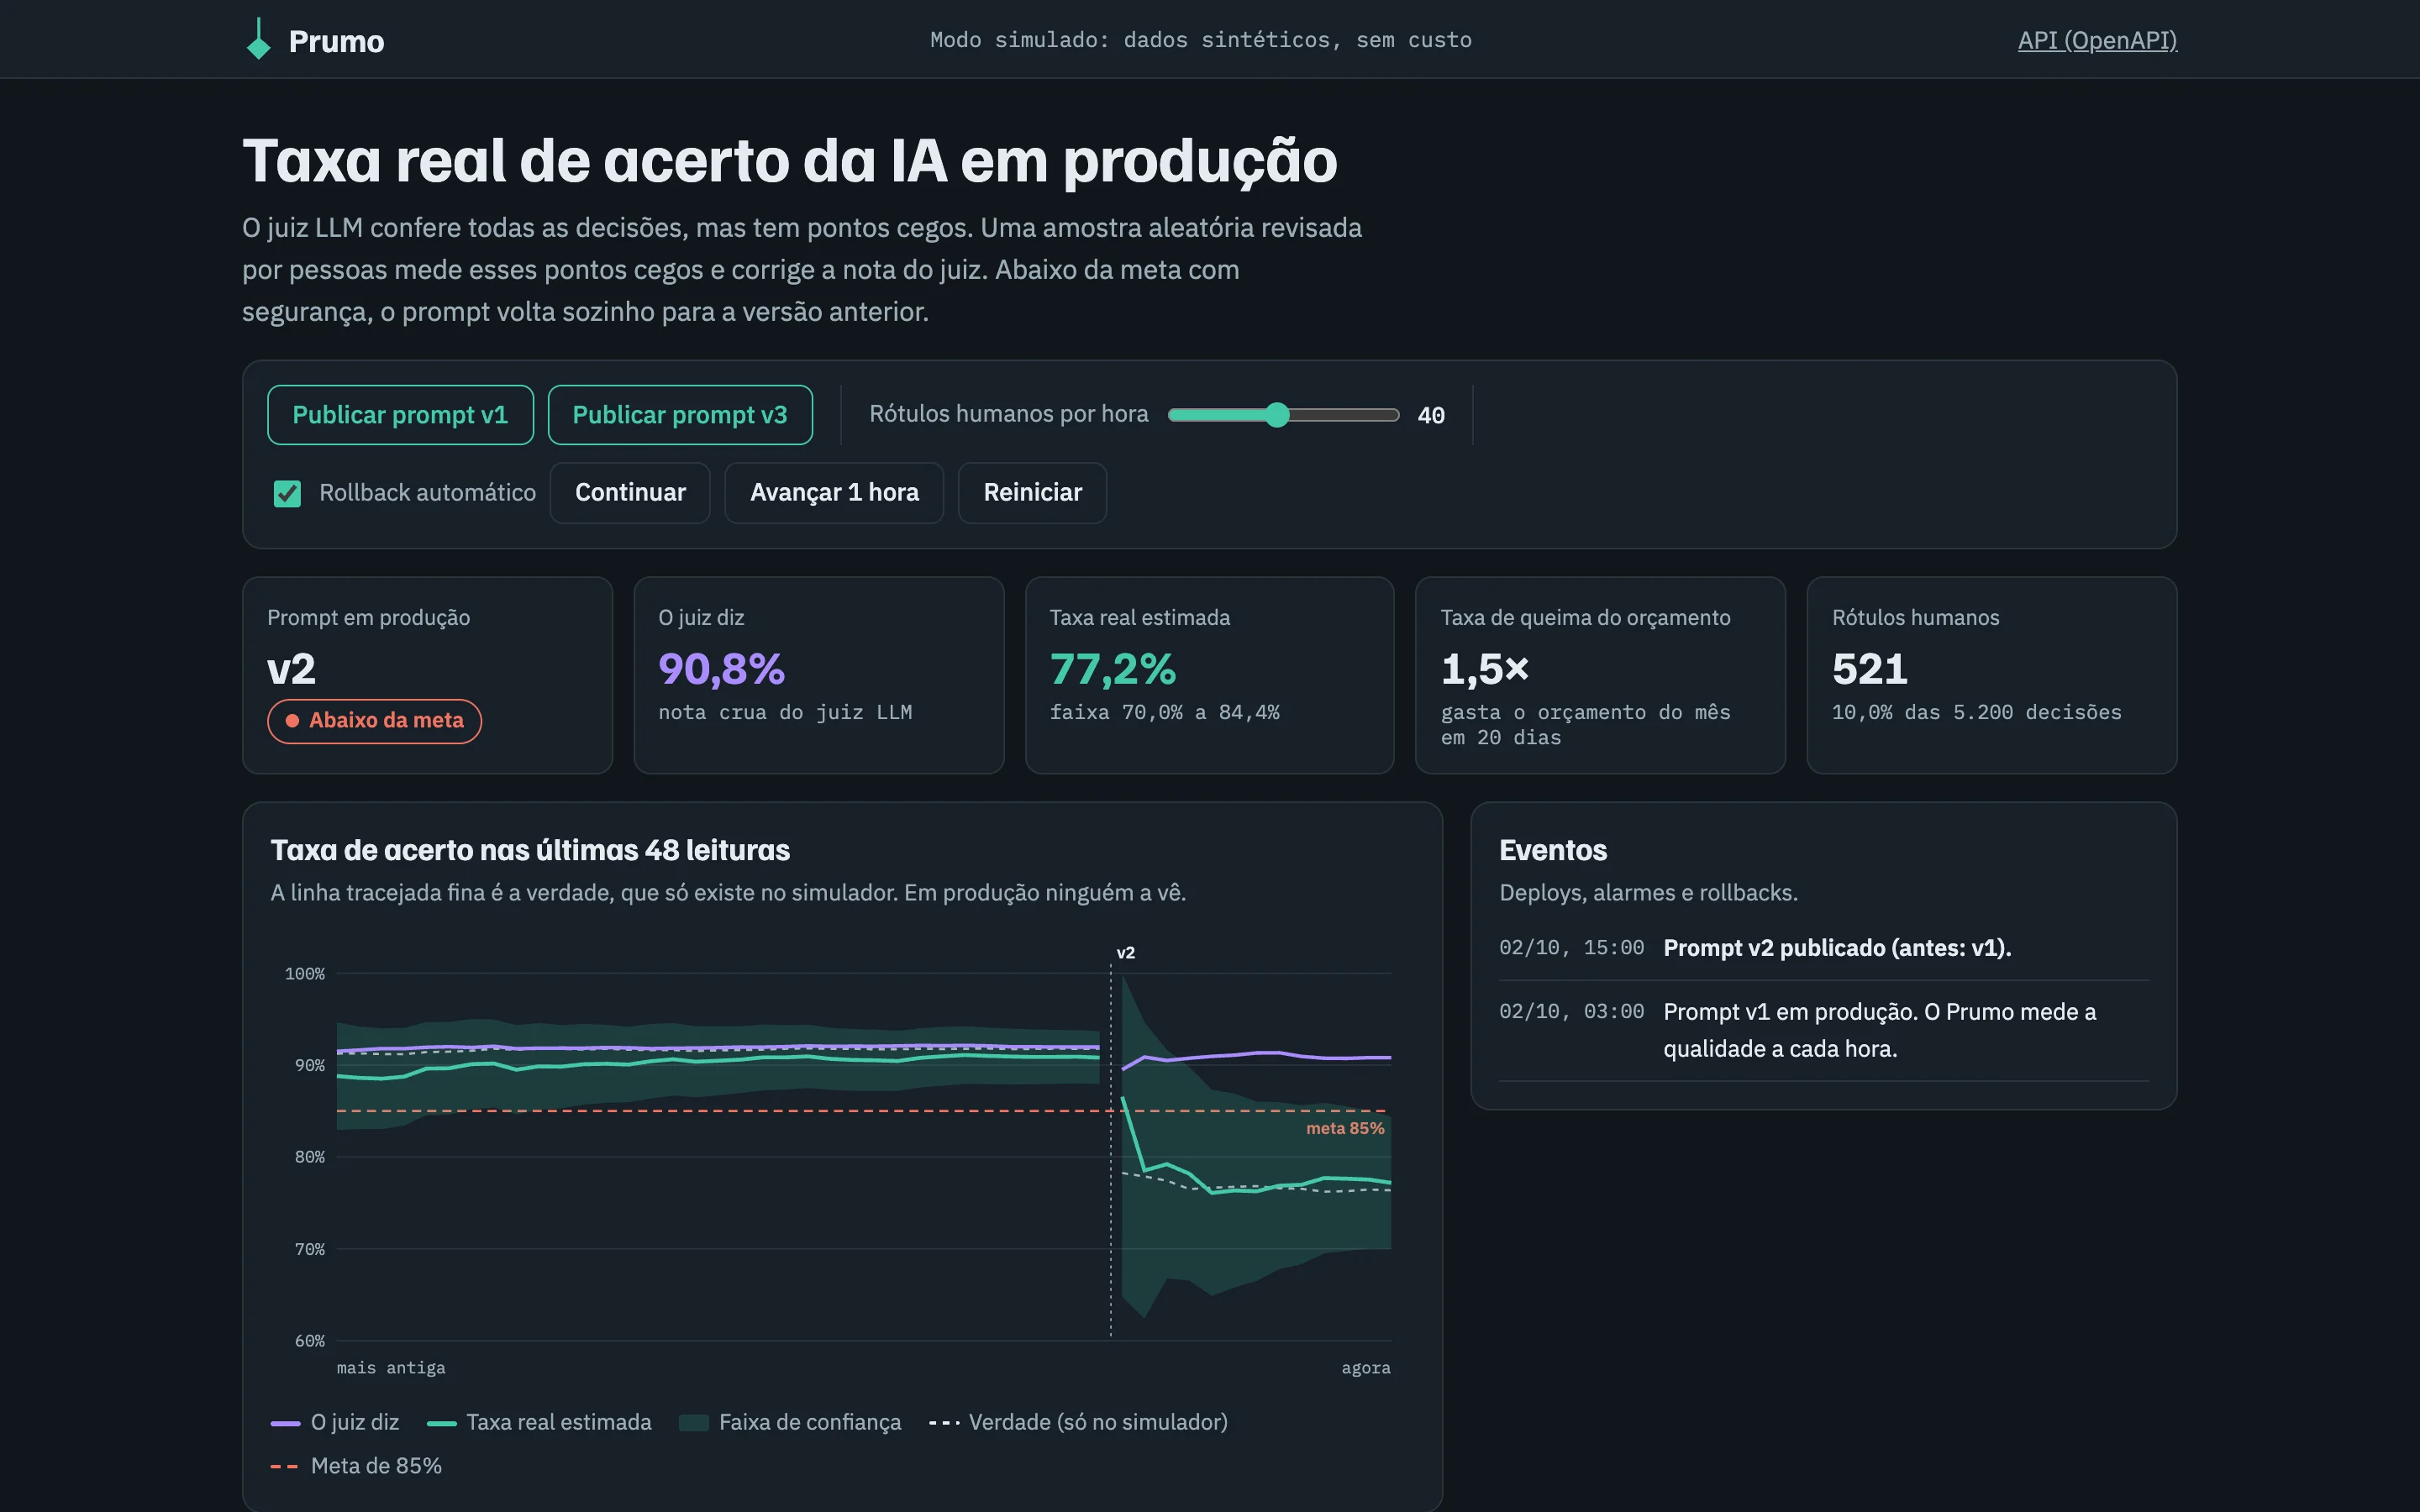
    Durante o incidente, o juiz segue perto de 91% enquanto a taxa real estimada da v2 cai abaixo da meta de 85%, e o status muda para Abaixo da meta. Simulador com dados fictícios.

    Painel do Prumo no tema escuro, no modo simulado, durante o incidente: controles para publicar os prompts v1 e v3, rótulos humanos por hora em 40 e rollback automático ligado; indicadores com o prompt v2 em produção e o status Abaixo da meta, o juiz dizendo 90,8%, a taxa real estimada de 77,2% com faixa de 70,0% a 84,4%, taxa de queima do orçamento de 1,5× e 521 rótulos humanos, 10% de 5.200 decisões; no gráfico, depois do marcador v2, a nota do juiz segue perto de 91% enquanto a taxa estimada e a verdade do simulador caem abaixo da meta de 85%; e, nos eventos, o deploy da v2, ainda sem rollback.
    Painel do Prumo no tema escuro, no modo simulado, durante o incidente: controles para publicar os prompts v1 e v3, rótulos humanos por hora em 40 e rollback automático ligado; indicadores com o prompt v2 em produção e o status Abaixo da meta, o juiz dizendo 90,8%, a taxa real estimada de 77,2% com faixa de 70,0% a 84,4%, taxa de queima do orçamento de 1,5× e 521 rótulos humanos, 10% de 5.200 decisões; no gráfico, depois do marcador v2, a nota do juiz segue perto de 91% enquanto a taxa estimada e a verdade do simulador caem abaixo da meta de 85%; e, nos eventos, o deploy da v2, ainda sem rollback.
  3. Indicadores no celular

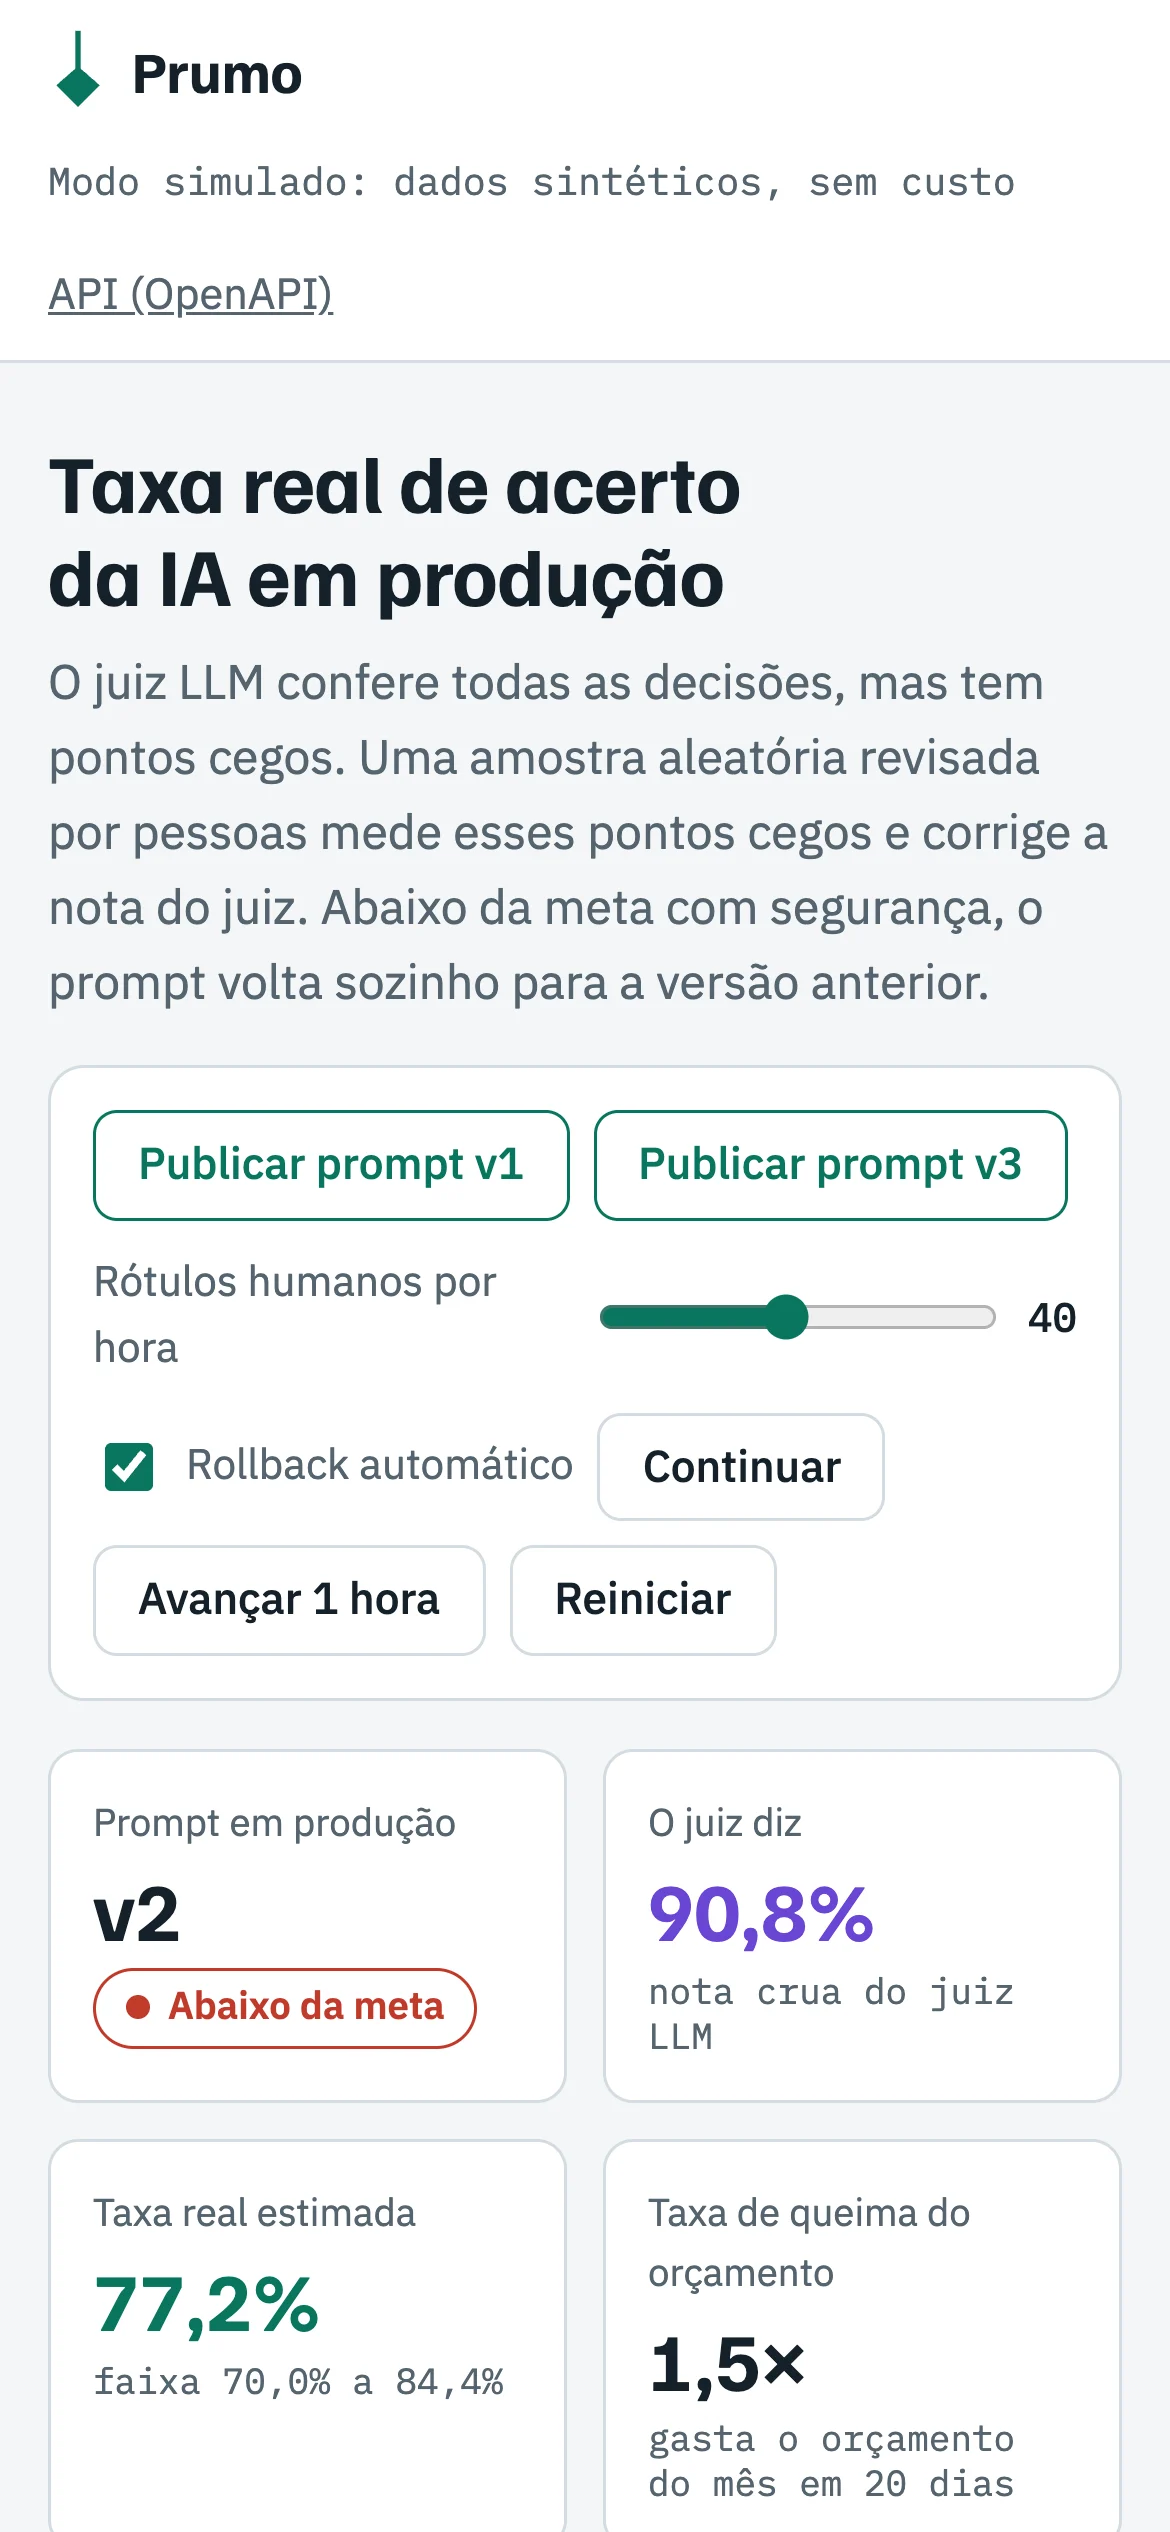
    No celular, os indicadores separam o que o juiz diz, 90,8%, da taxa real estimada, 77,2%, com a faixa de confiança e a taxa de queima do orçamento logo ao lado. Dados fictícios.

    • Topo do painel do Prumo no celular, no modo simulado, durante o incidente: botões para publicar os prompts v1 e v3, rótulos humanos por hora em 40 e rollback automático ligado; indicadores com o prompt v2 em produção e o status Abaixo da meta, a nota crua do juiz LLM no cartão O juiz diz, 90,8%, a taxa real estimada de 77,2% com faixa de 70,0% a 84,4% e a taxa de queima do orçamento de 1,5×, que gasta o orçamento do mês em 20 dias.
      Topo do painel do Prumo no celular, no modo simulado, durante o incidente: botões para publicar os prompts v1 e v3, rótulos humanos por hora em 40 e rollback automático ligado; indicadores com o prompt v2 em produção e o status Abaixo da meta, a nota crua do juiz LLM no cartão O juiz diz, 90,8%, a taxa real estimada de 77,2% com faixa de 70,0% a 84,4% e a taxa de queima do orçamento de 1,5×, que gasta o orçamento do mês em 20 dias.
  4. Revisão humana e eventos

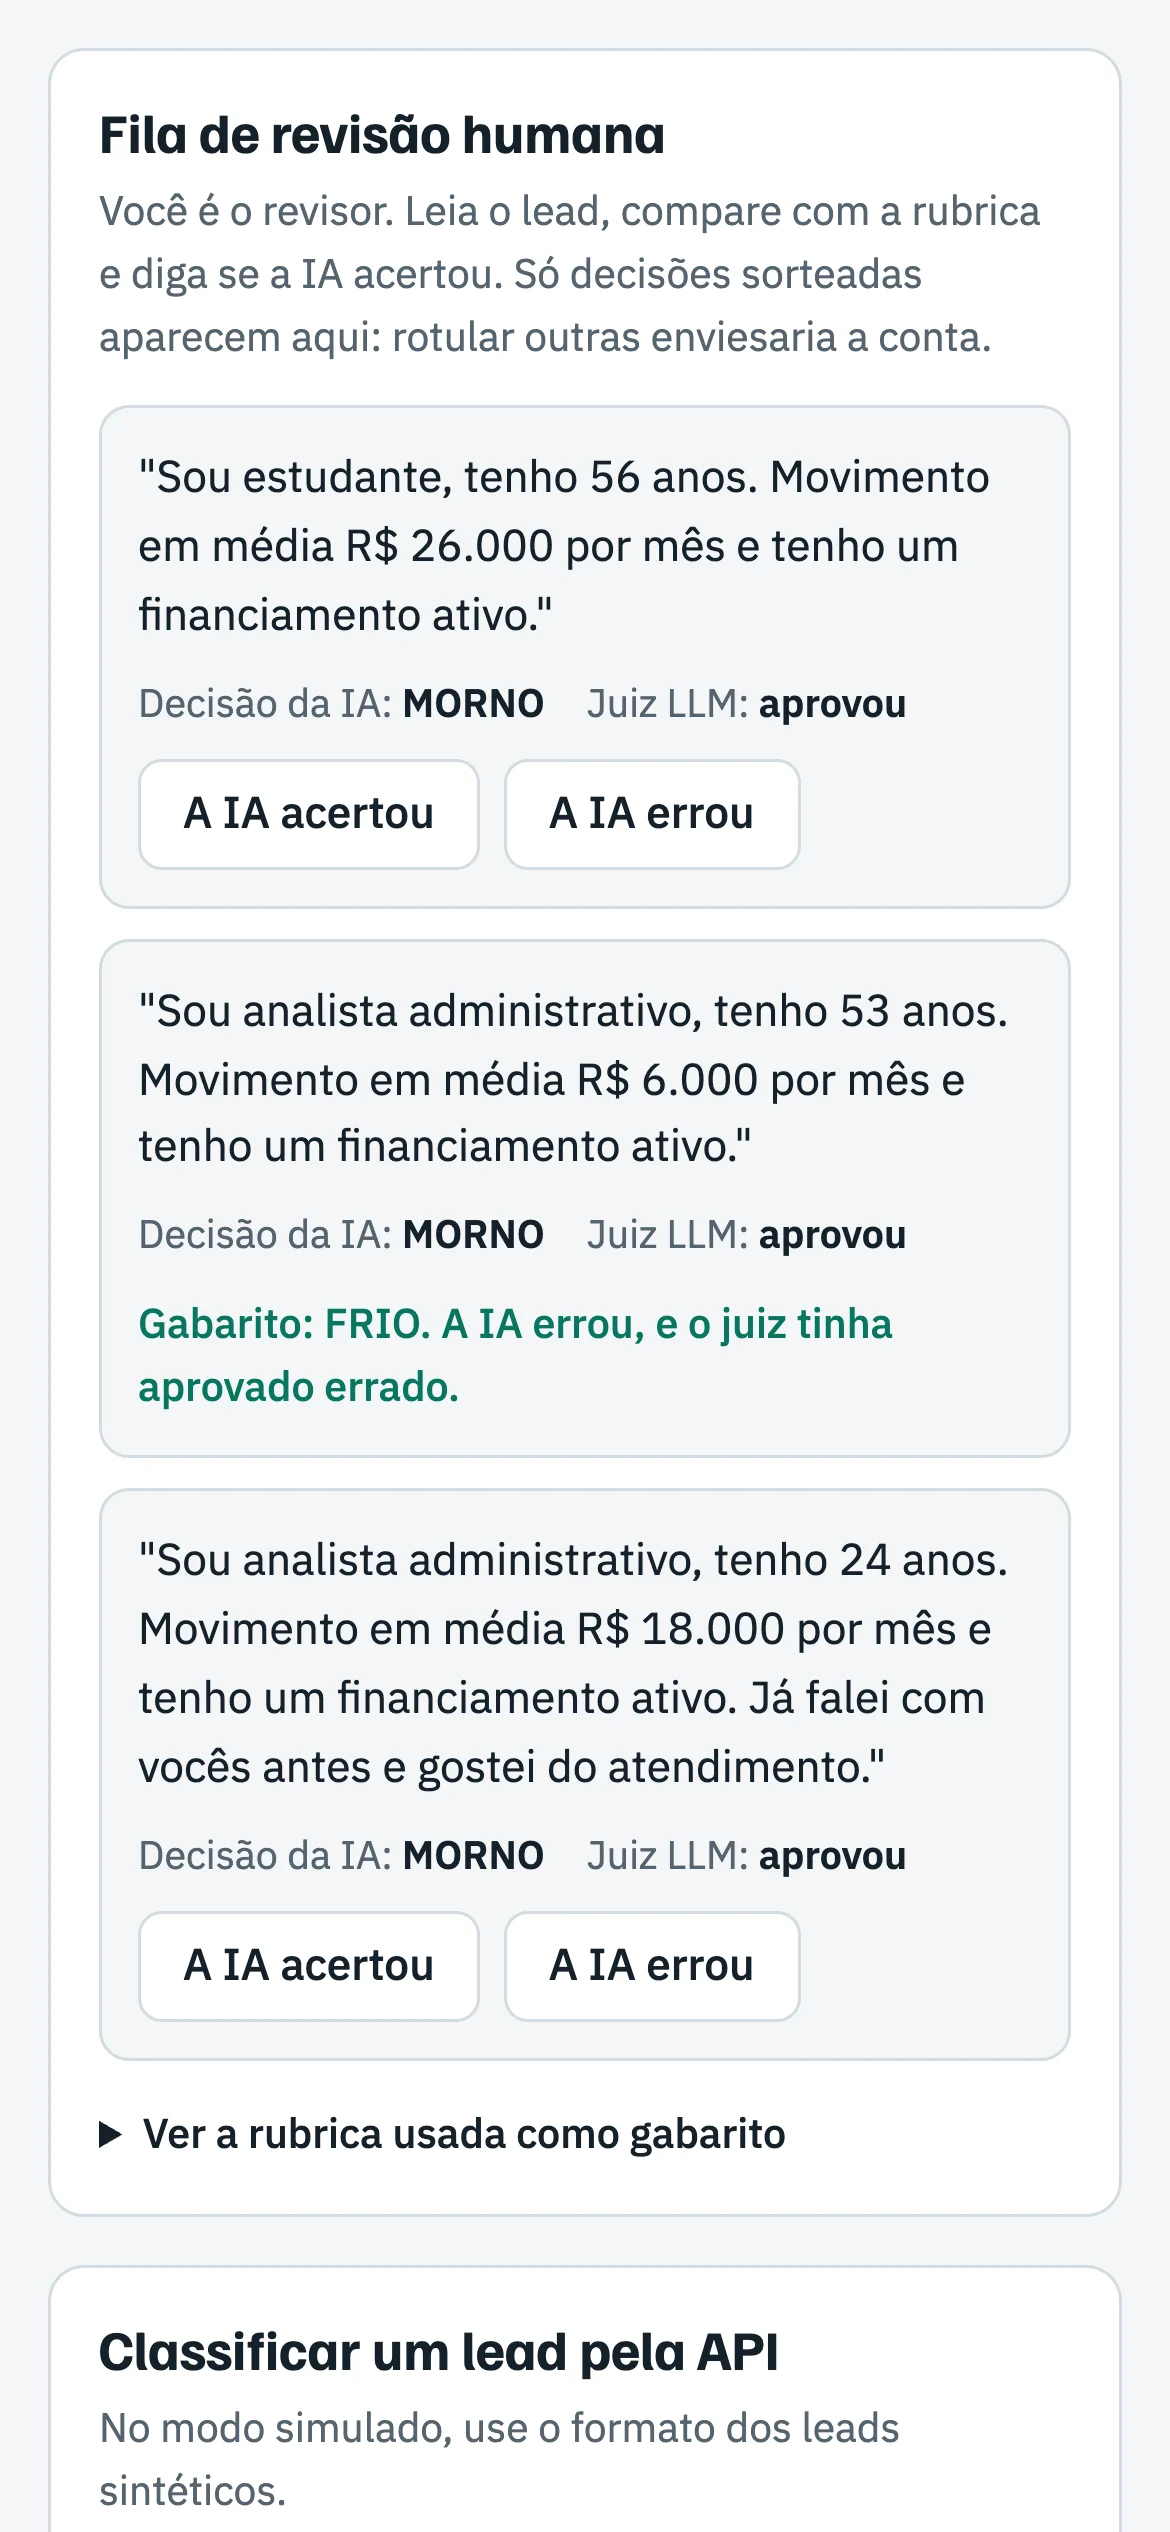
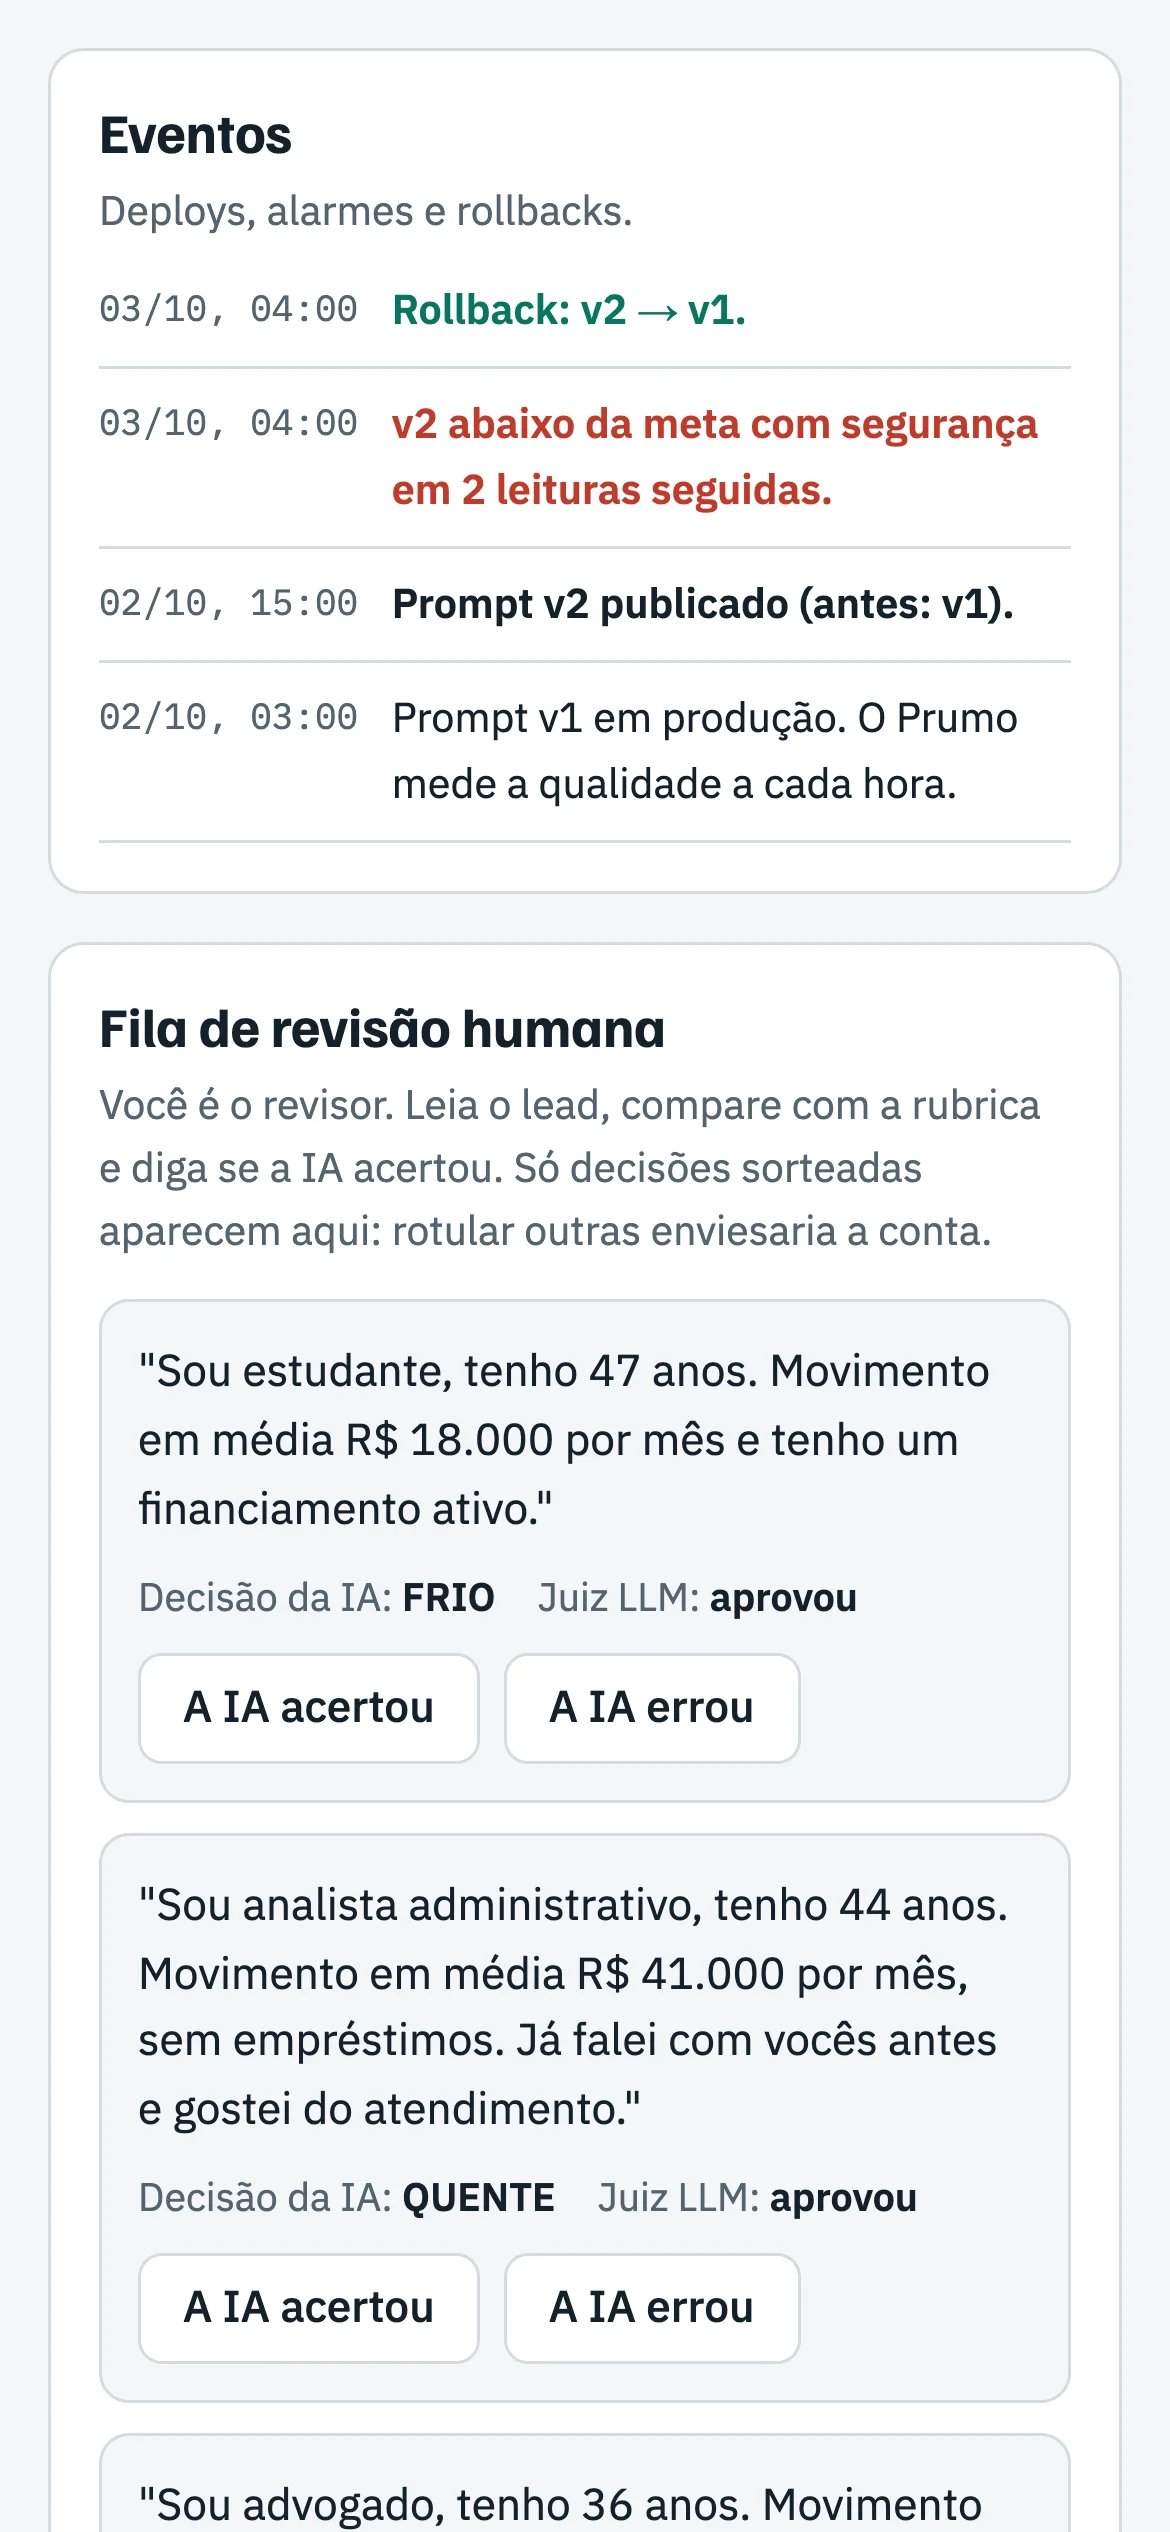
    Na fila de revisão, a pessoa diz se a IA acertou e vê o gabarito do simulador; os eventos registram deploys, alarmes e rollbacks com data e hora. Dados fictícios.

    • Fila de revisão humana no celular, com o aviso de que só decisões sorteadas aparecem: três leads sintéticos em texto, com profissão, idade, movimentação mensal e financiamento, cada um com a decisão da IA, MORNO, e o juiz LLM tendo aprovado; dois têm os botões A IA acertou e A IA errou, e o do meio, já rotulado, mostra Gabarito: FRIO. A IA errou, e o juiz tinha aprovado errado. Abaixo, o link para ver a rubrica usada como gabarito.
      Fila de revisão humana no celular, com o aviso de que só decisões sorteadas aparecem: três leads sintéticos em texto, com profissão, idade, movimentação mensal e financiamento, cada um com a decisão da IA, MORNO, e o juiz LLM tendo aprovado; dois têm os botões A IA acertou e A IA errou, e o do meio, já rotulado, mostra Gabarito: FRIO. A IA errou, e o juiz tinha aprovado errado. Abaixo, o link para ver a rubrica usada como gabarito.
    • Lista de eventos do Prumo no celular, da mais recente para a mais antiga, com data e hora: rollback de v2 para v1; v2 abaixo da meta com segurança em 2 leituras seguidas; prompt v2 publicado, antes v1; e prompt v1 em produção, com o Prumo medindo a qualidade a cada hora. Abaixo, o início da fila de revisão humana com dois leads sintéticos aprovados pelo juiz.
      Lista de eventos do Prumo no celular, da mais recente para a mais antiga, com data e hora: rollback de v2 para v1; v2 abaixo da meta com segurança em 2 leituras seguidas; prompt v2 publicado, antes v1; e prompt v1 em produção, com o Prumo medindo a qualidade a cada hora. Abaixo, o início da fila de revisão humana com dois leads sintéticos aprovados pelo juiz.
  5. Fundamentos do design system

    Dez tokens de cor em claro e escuro, tipografia, raios e espaçamentos sustentam o painel em Jinja2 e JavaScript sem framework, dos botões em cada estado aos status do SLO.
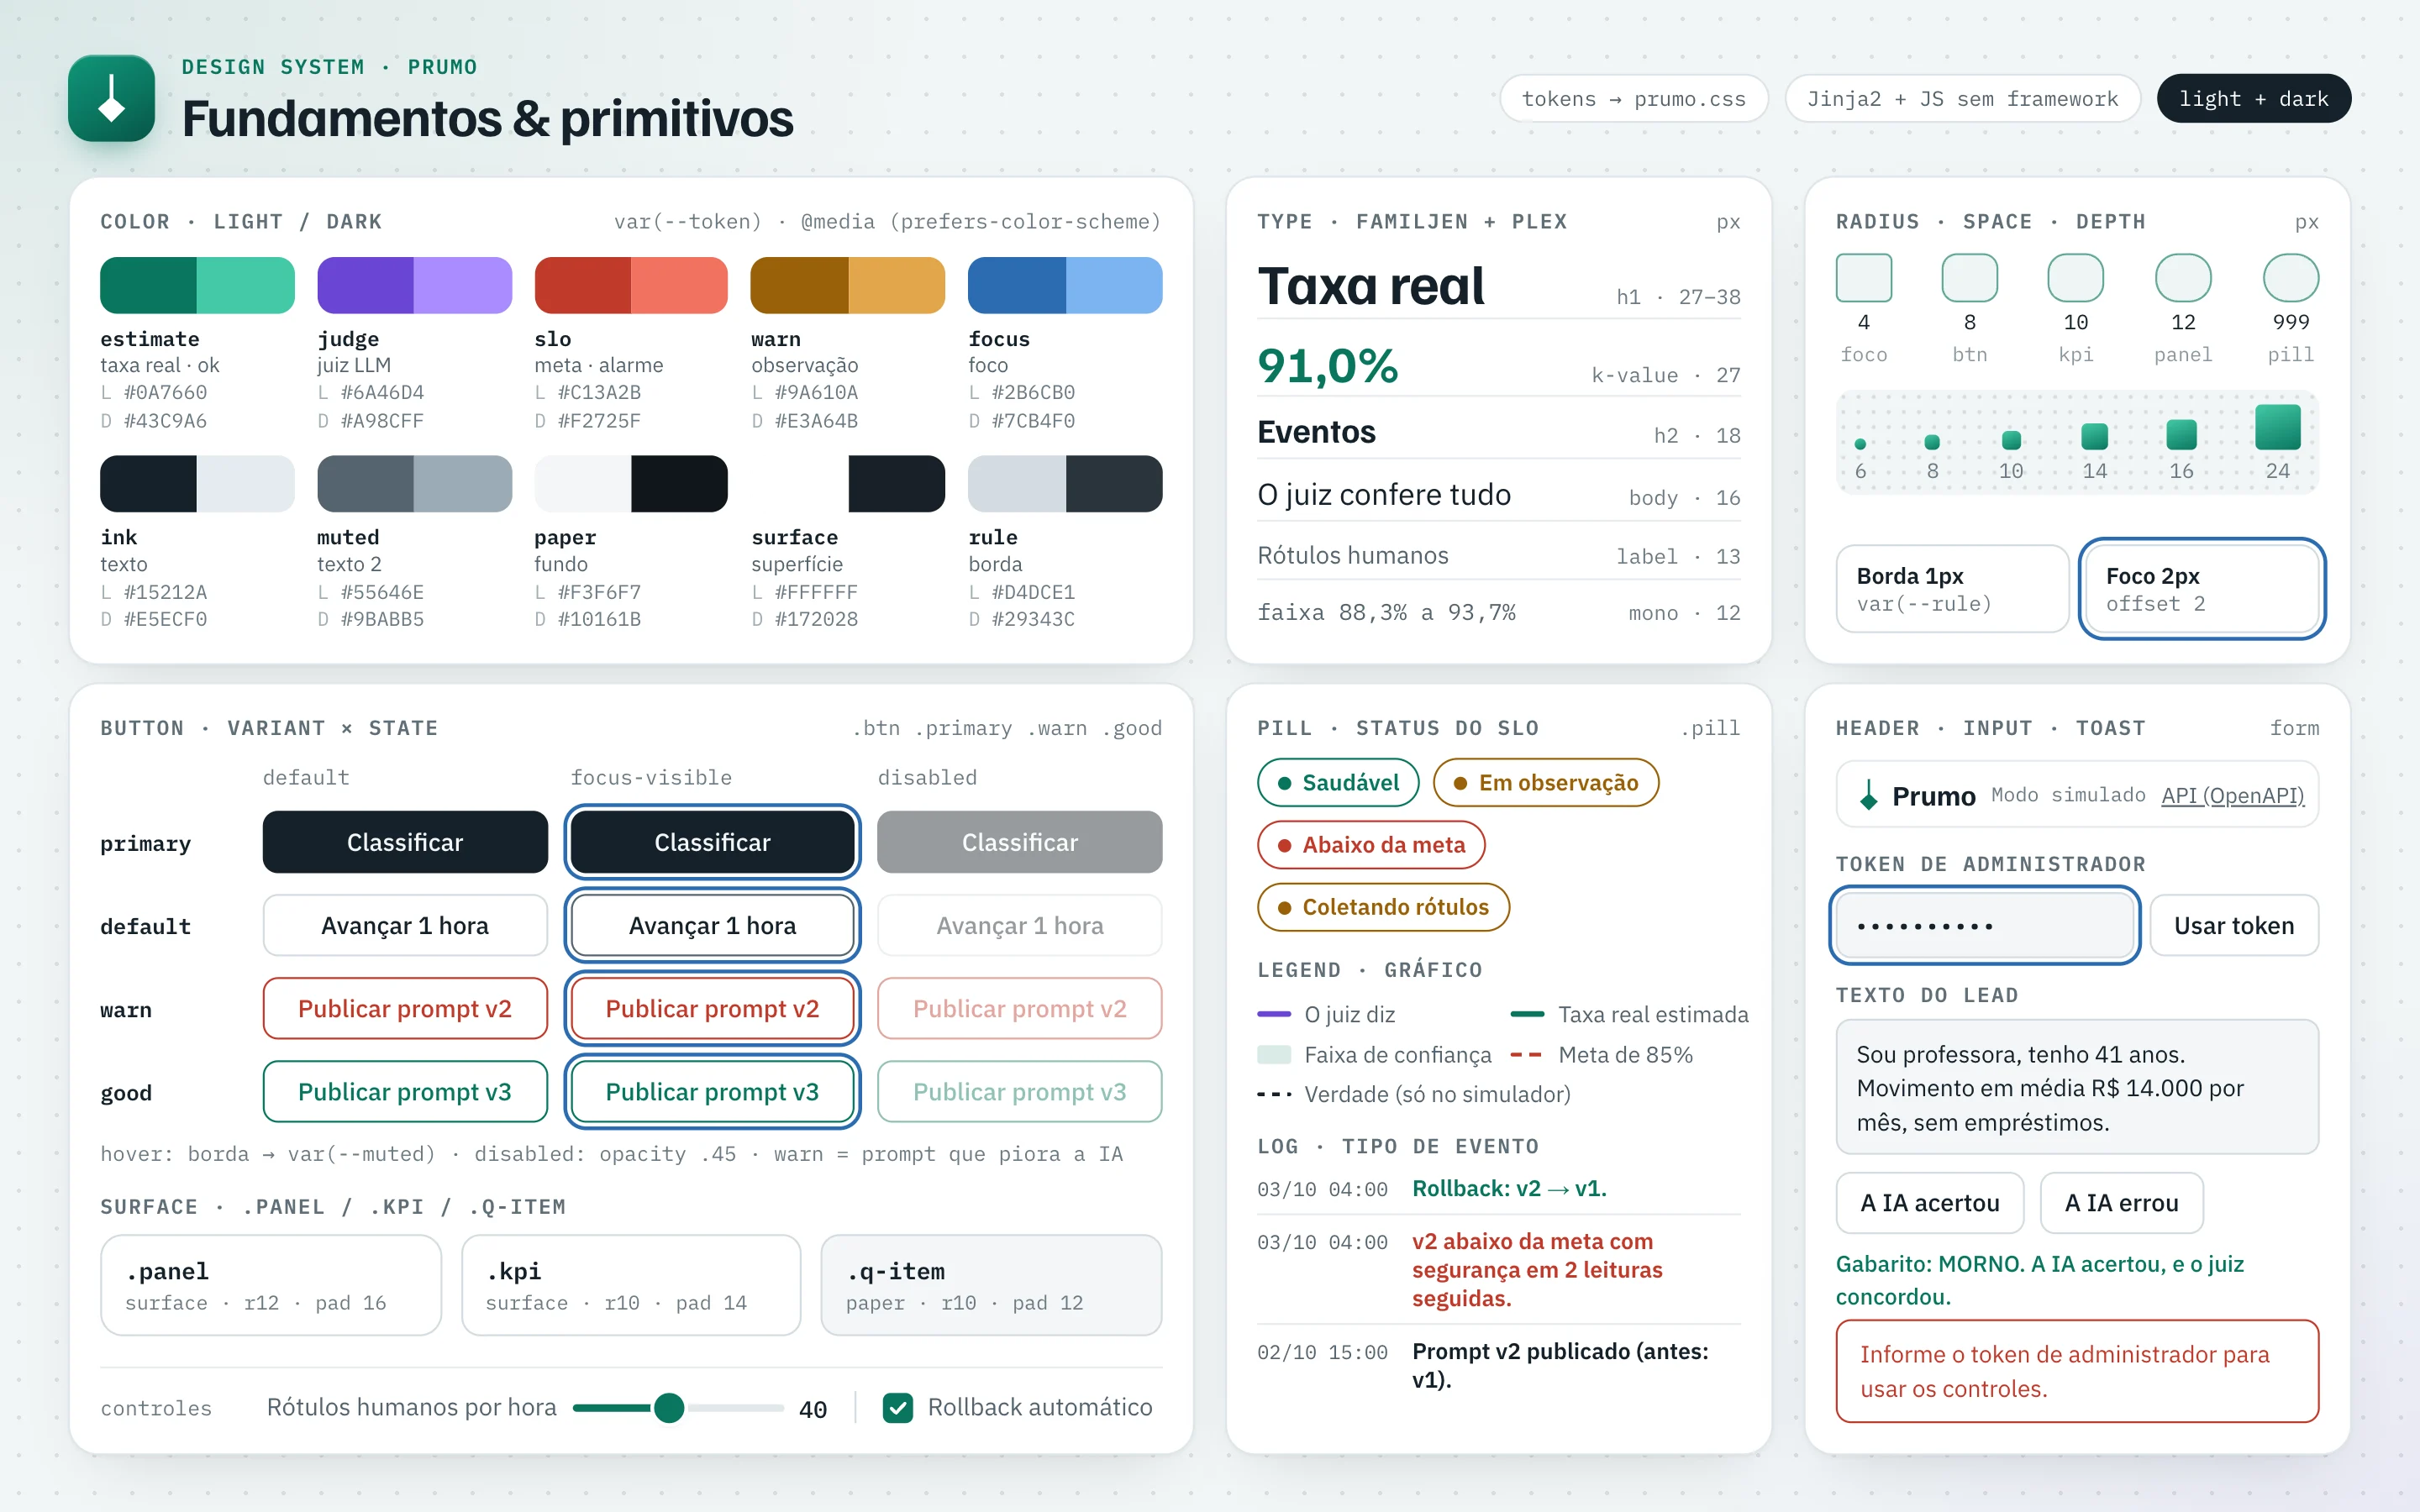
    Prancha do design system do Prumo, fundamentos e primitivos, com o símbolo do prumo ao lado do título e os chips tokens em prumo.css, Jinja2 com JavaScript sem framework e light + dark. Cor: dez tokens em pares claro e escuro com hexadecimais, estimate (taxa real), judge (juiz LLM), slo (meta e alarme), warn (observação), focus, ink, muted, paper, surface e rule. Tipografia em Familjen Grotesk e IBM Plex, do título Taxa real ao número 91,0% e à faixa de 88,3% a 93,7% em mono. Raios de 4 a 999 px, espaçamentos de 6 a 24 px, borda de 1 px e foco de 2 px. Botões primary, default, warn e good nos estados padrão, focus-visible e desabilitado; as superfícies panel, kpi e q-item; os controles de rótulos humanos por hora e de rollback automático; os status do SLO Saudável, Em observação, Abaixo da meta e Coletando rótulos; a legenda do gráfico; os tipos de evento do log; e o cabeçalho, o campo do token de administrador, o texto do lead e o aviso de erro.
    Prancha do design system do Prumo, fundamentos e primitivos, com o símbolo do prumo ao lado do título e os chips tokens em prumo.css, Jinja2 com JavaScript sem framework e light + dark. Cor: dez tokens em pares claro e escuro com hexadecimais, estimate (taxa real), judge (juiz LLM), slo (meta e alarme), warn (observação), focus, ink, muted, paper, surface e rule. Tipografia em Familjen Grotesk e IBM Plex, do título Taxa real ao número 91,0% e à faixa de 88,3% a 93,7% em mono. Raios de 4 a 999 px, espaçamentos de 6 a 24 px, borda de 1 px e foco de 2 px. Botões primary, default, warn e good nos estados padrão, focus-visible e desabilitado; as superfícies panel, kpi e q-item; os controles de rótulos humanos por hora e de rollback automático; os status do SLO Saudável, Em observação, Abaixo da meta e Coletando rótulos; a legenda do gráfico; os tipos de evento do log; e o cabeçalho, o campo do token de administrador, o texto do lead e o aviso de erro.
  6. Componentes de domínio

    Os componentes de domínio põem o juiz ao lado da taxa real, mostram o status do SLO, as 48 leituras e os eventos de deploy, alarme e rollback e organizam a revisão humana, nos dois temas. Dados fictícios.
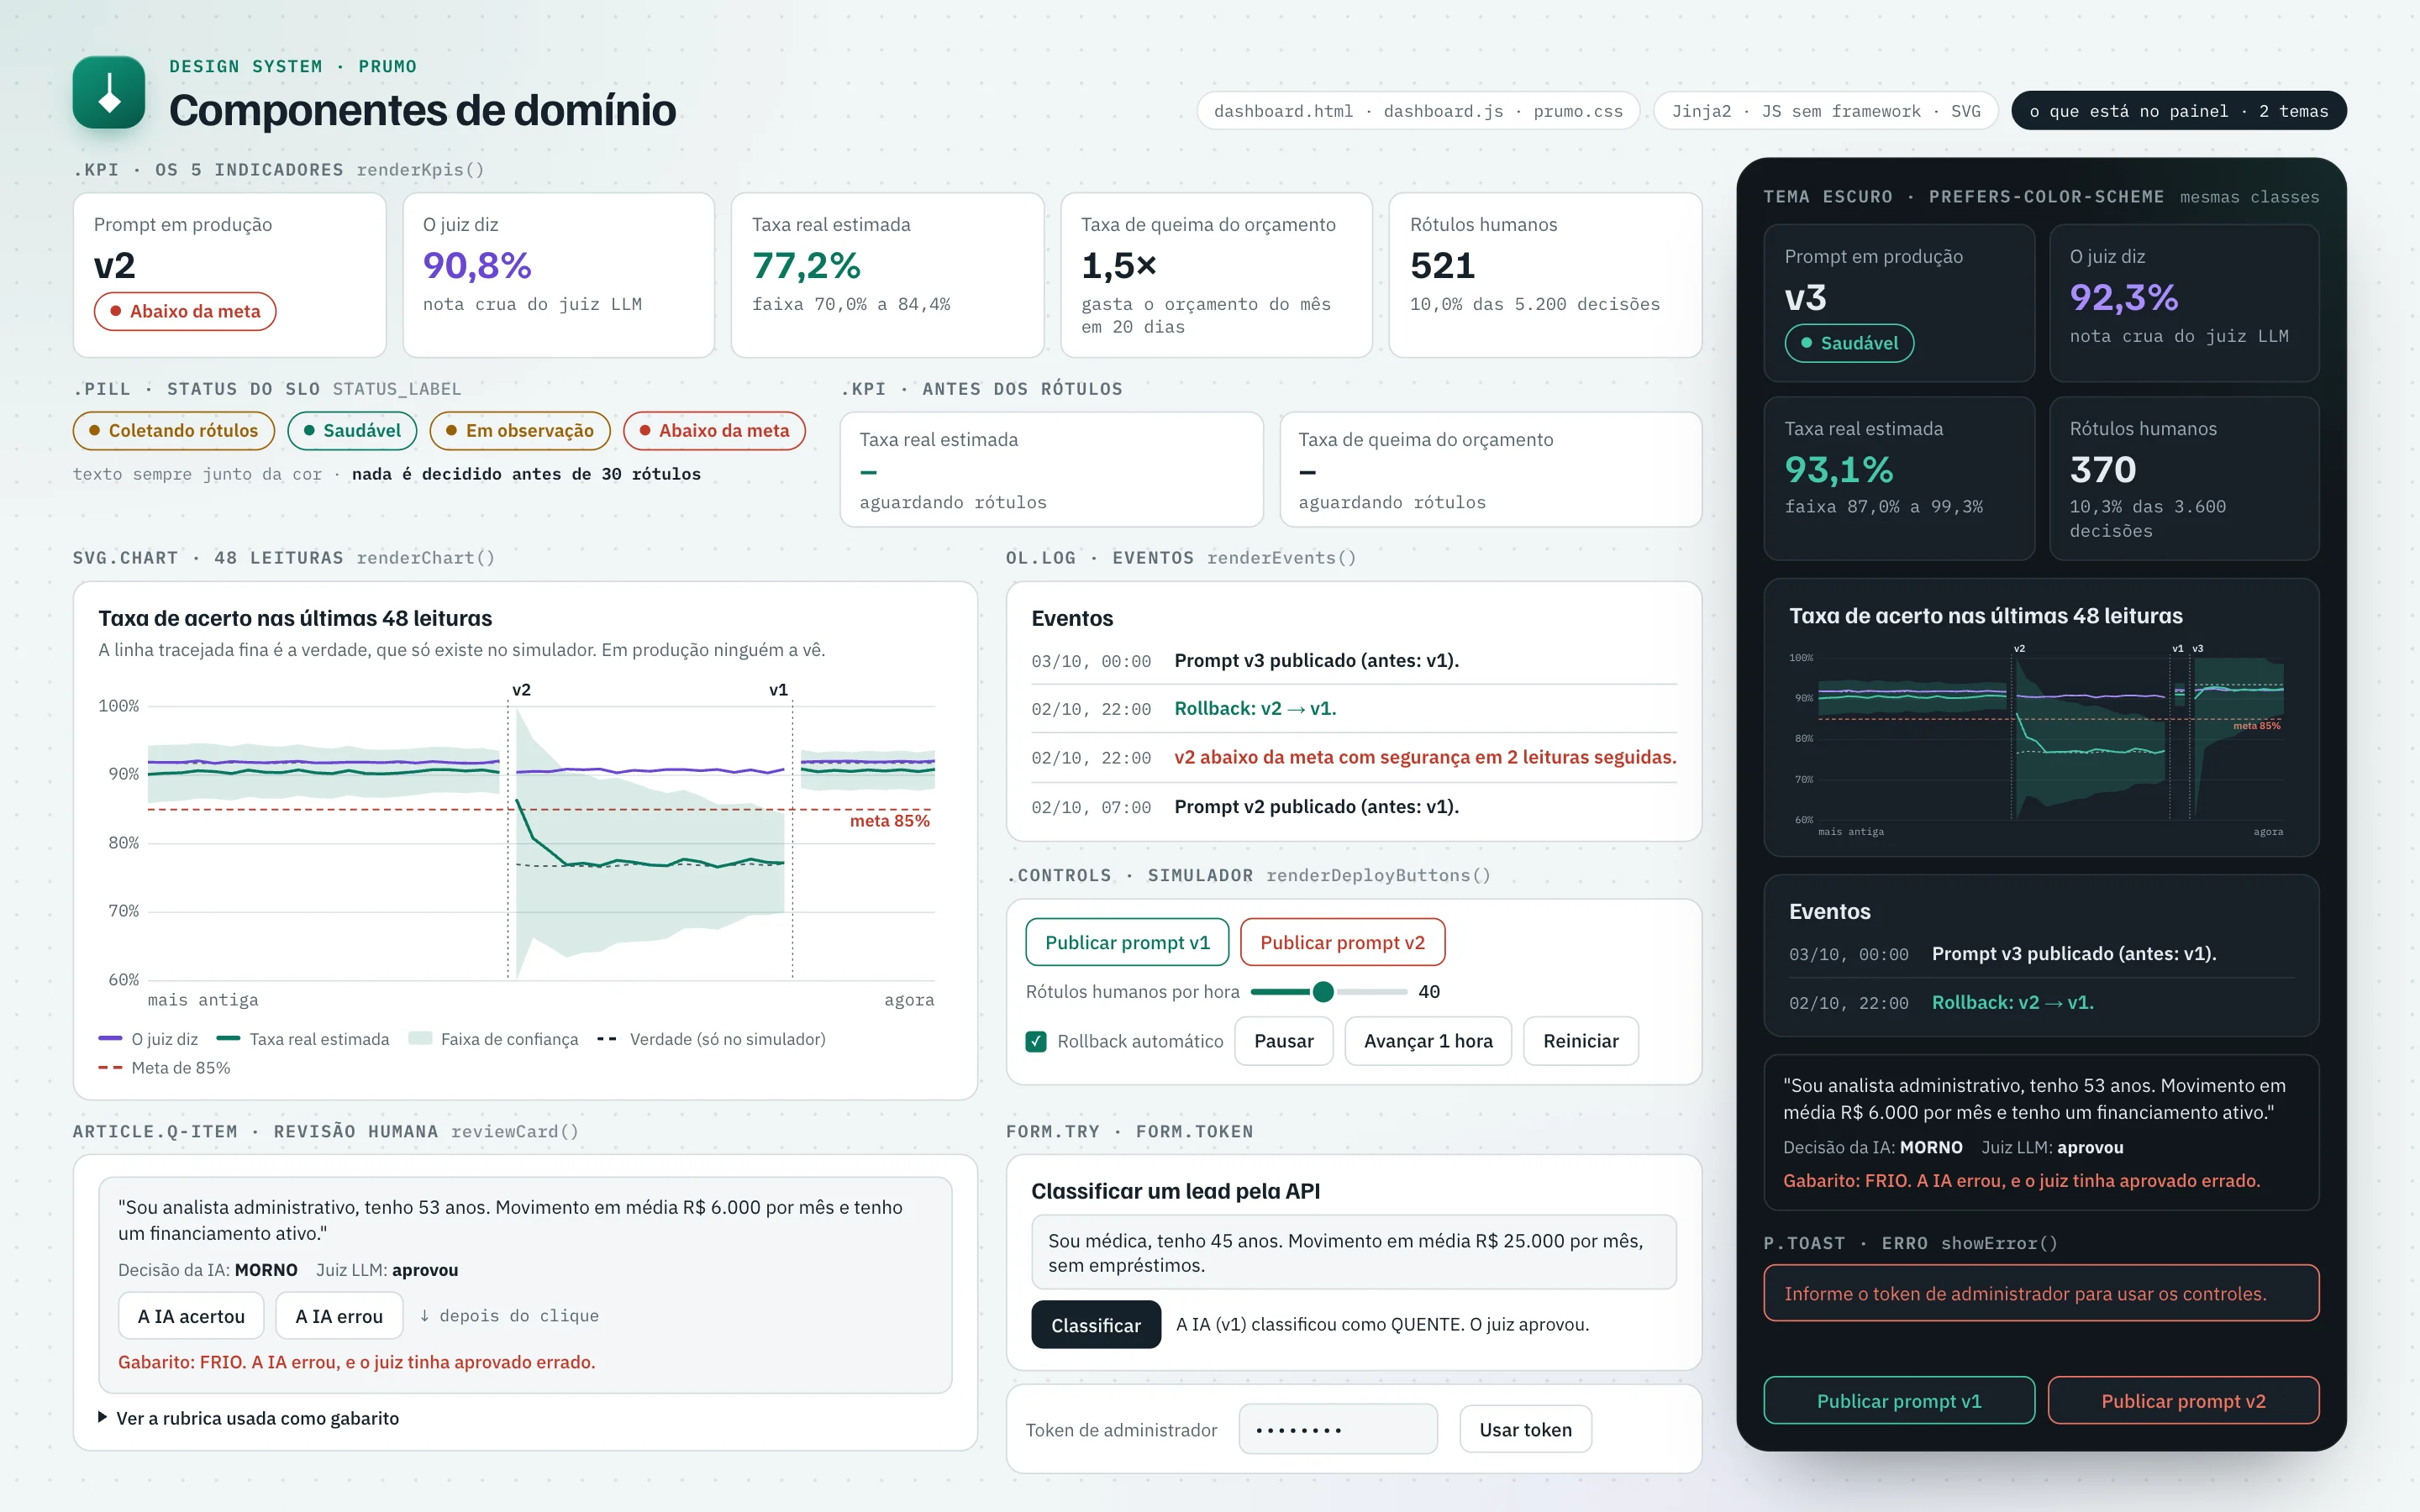
    Prancha de componentes de domínio do Prumo, só com o que está no painel e dados fictícios: os 5 indicadores (prompt em produção v2 com o status Abaixo da meta, o juiz diz 90,8%, taxa real estimada 77,2% com a faixa de 70,0% a 84,4%, taxa de queima do orçamento 1,5× e 521 rótulos humanos); os 4 status do SLO, Coletando rótulos, Saudável, Em observação e Abaixo da meta, e os indicadores aguardando rótulos; o gráfico das últimas 48 leituras com as linhas do juiz, da taxa real, da faixa e da verdade do simulador; a lista de eventos de deploy, alarme e rollback; os controles do simulador; o cartão da revisão humana com o gabarito depois do clique; o formulário de classificar um lead, o campo do token de administrador e o aviso de erro; e, num painel escuro, os mesmos componentes com os tokens do tema escuro.
    Prancha de componentes de domínio do Prumo, só com o que está no painel e dados fictícios: os 5 indicadores (prompt em produção v2 com o status Abaixo da meta, o juiz diz 90,8%, taxa real estimada 77,2% com a faixa de 70,0% a 84,4%, taxa de queima do orçamento 1,5× e 521 rótulos humanos); os 4 status do SLO, Coletando rótulos, Saudável, Em observação e Abaixo da meta, e os indicadores aguardando rótulos; o gráfico das últimas 48 leituras com as linhas do juiz, da taxa real, da faixa e da verdade do simulador; a lista de eventos de deploy, alarme e rollback; os controles do simulador; o cartão da revisão humana com o gabarito depois do clique; o formulário de classificar um lead, o campo do token de administrador e o aviso de erro; e, num painel escuro, os mesmos componentes com os tokens do tema escuro.
  7. Como a conta funciona

    Num exemplo de 20 decisões, o juiz aprova 90%, a amostra humana mostra 75% e a faixa abaixo da meta aciona o rollback. A sequência de confiança continua válida mesmo consultada a cada hora.
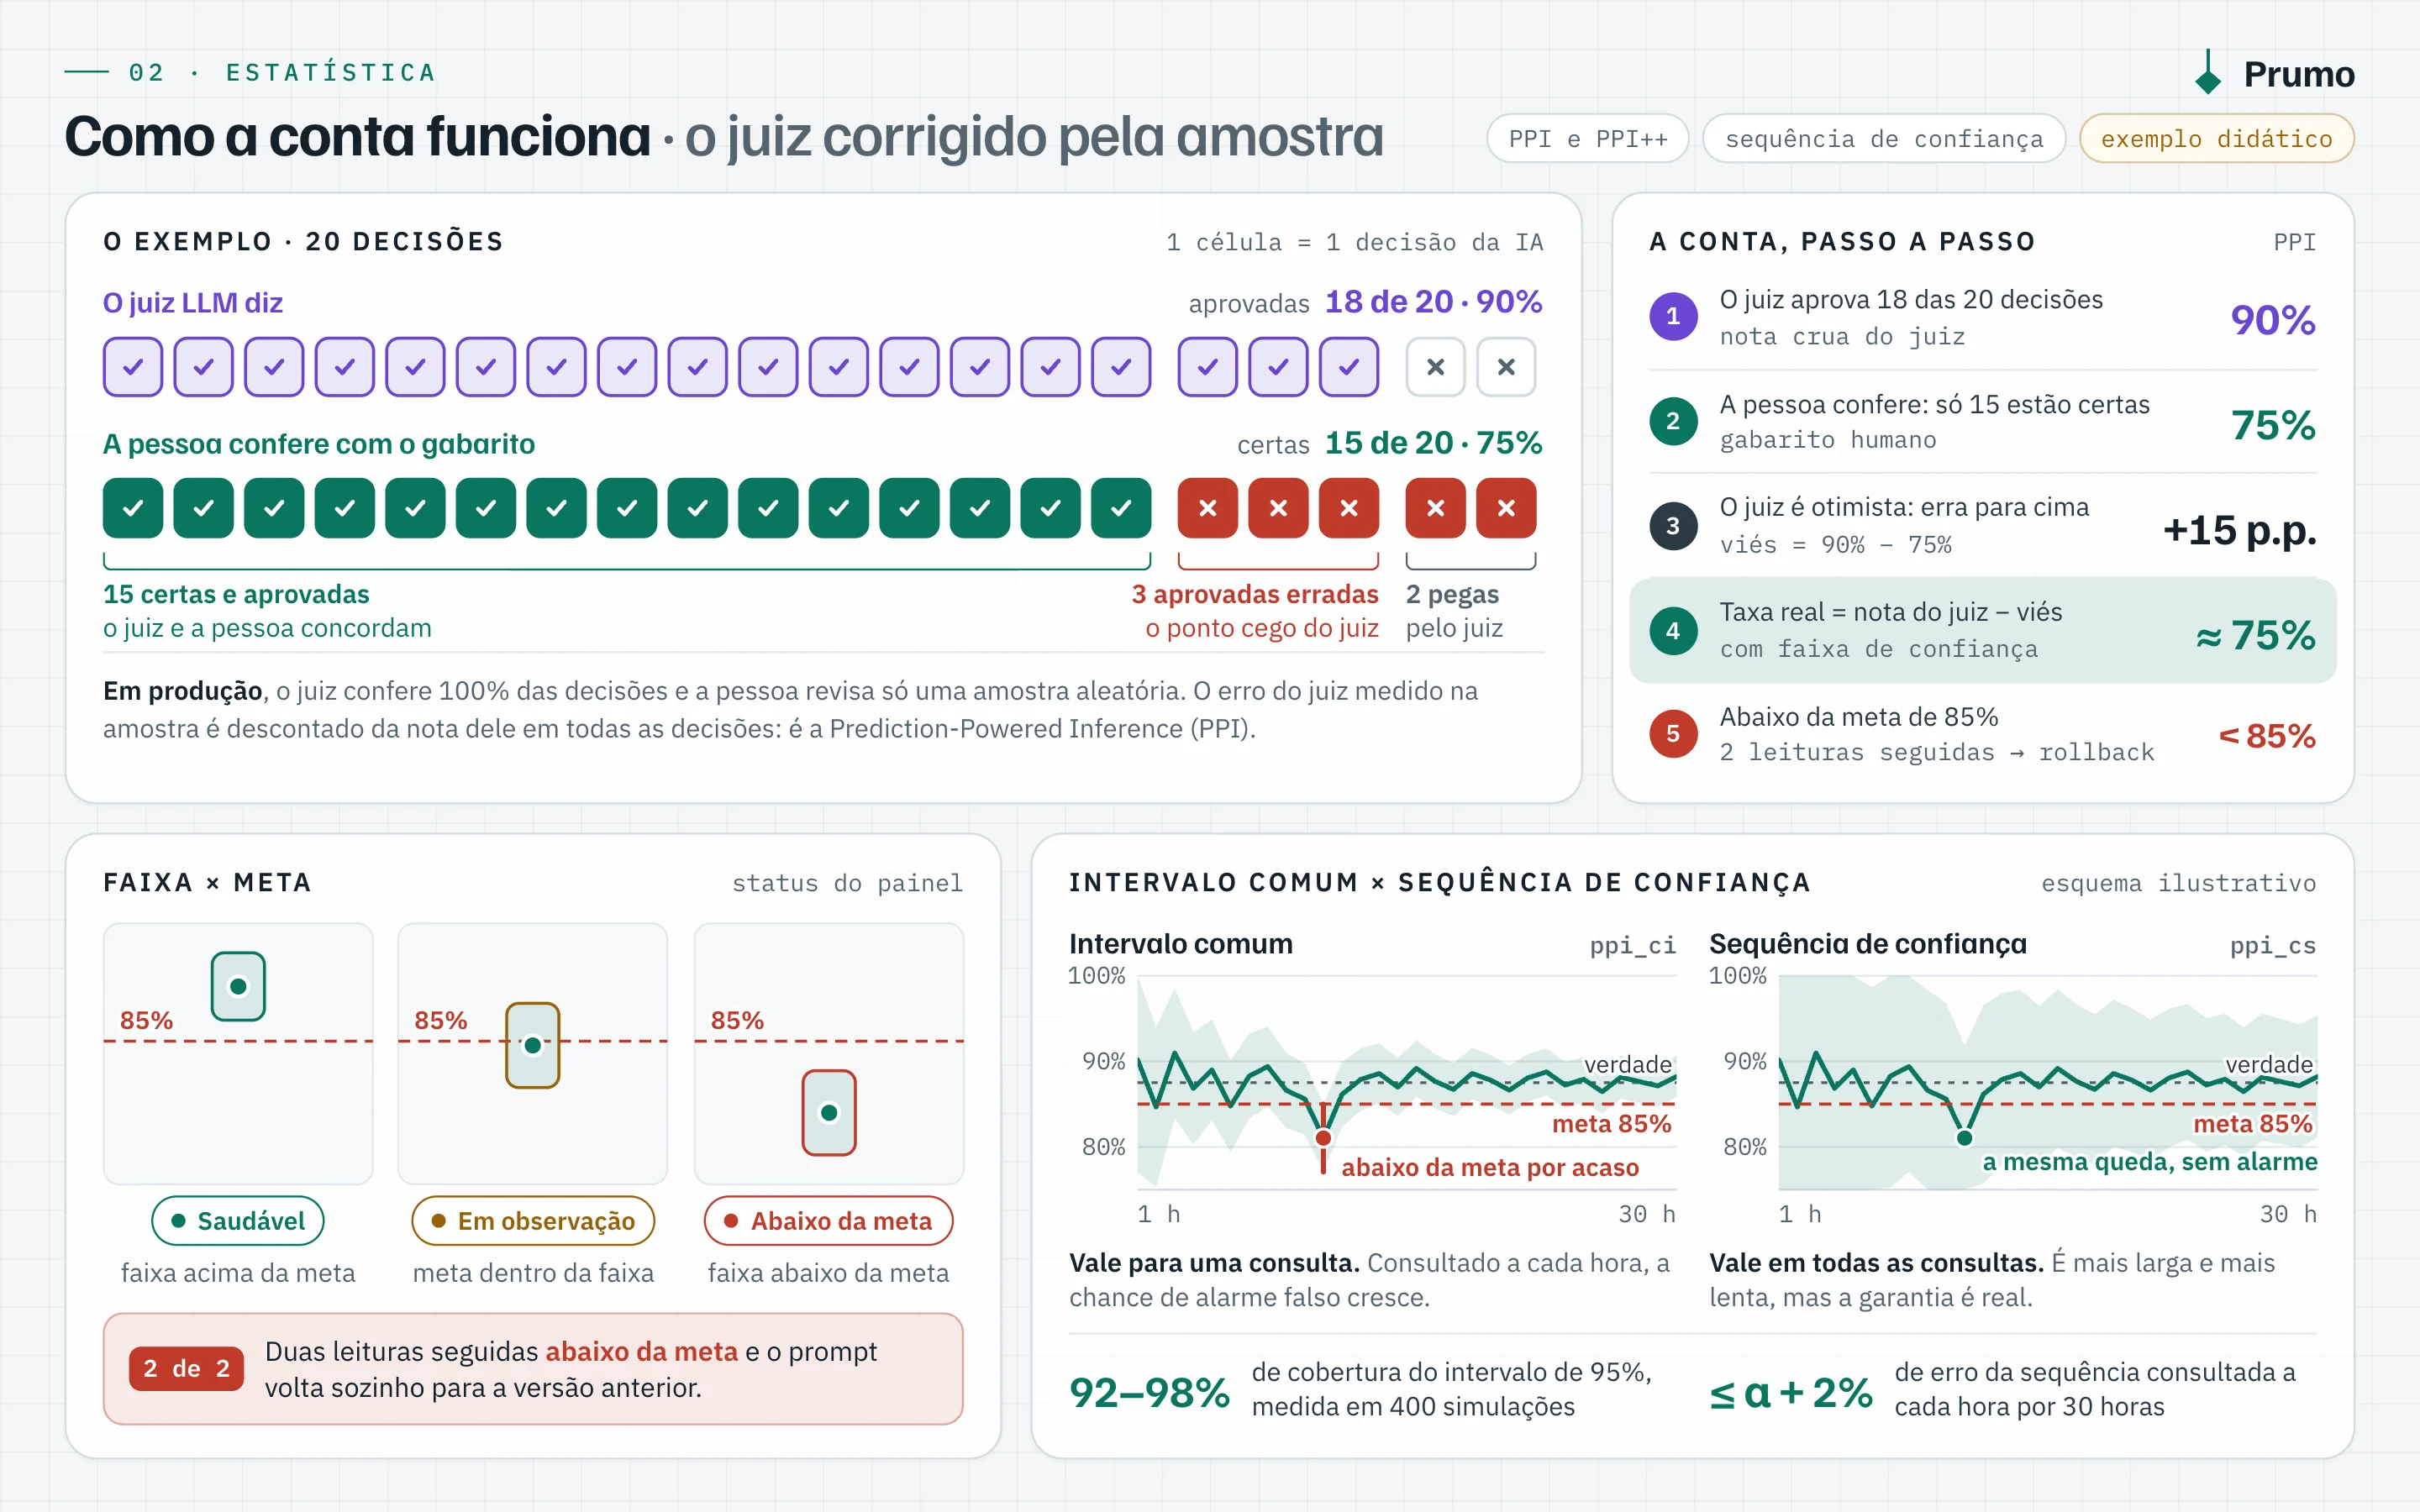
    Prancha didática de como a conta funciona. Num exemplo de 20 decisões, o juiz LLM aprova 18, ou 90%; a pessoa confere com o gabarito e só 15 estão certas, ou 75%: 15 certas e aprovadas, 3 erradas que o juiz aprovou, o ponto cego dele, e 2 que o juiz pegou. A conta passo a passo: o juiz é otimista em 15 pontos percentuais, a taxa real fica em cerca de 75% com faixa de confiança e, abaixo da meta de 85% em 2 leituras seguidas, o prompt volta. Abaixo, a faixa contra a meta nos três status do painel, Saudável, Em observação e Abaixo da meta, e um esquema ilustrativo do intervalo comum (ppi_ci), que vale para uma consulta e alarma por acaso, contra a sequência de confiança (ppi_cs), mais larga e válida em todas as consultas, com 92% a 98% de cobertura do intervalo de 95% em 400 simulações e erro de no máximo α + 2% consultada a cada hora por 30 horas.
    Prancha didática de como a conta funciona. Num exemplo de 20 decisões, o juiz LLM aprova 18, ou 90%; a pessoa confere com o gabarito e só 15 estão certas, ou 75%: 15 certas e aprovadas, 3 erradas que o juiz aprovou, o ponto cego dele, e 2 que o juiz pegou. A conta passo a passo: o juiz é otimista em 15 pontos percentuais, a taxa real fica em cerca de 75% com faixa de confiança e, abaixo da meta de 85% em 2 leituras seguidas, o prompt volta. Abaixo, a faixa contra a meta nos três status do painel, Saudável, Em observação e Abaixo da meta, e um esquema ilustrativo do intervalo comum (ppi_ci), que vale para uma consulta e alarma por acaso, contra a sequência de confiança (ppi_cs), mais larga e válida em todas as consultas, com 92% a 98% de cobertura do intervalo de 95% em 400 simulações e erro de no máximo α + 2% consultada a cada hora por 30 horas.
  8. Arquitetura na AWS

    O quadro segue o lead de 1 a 12: API Gateway, Lambda com FastAPI, Bedrock com o juiz, DynamoDB, revisão humana no Step Functions, estimador de hora em hora, alarme no CloudWatch e rollback do prompt no AppConfig por compare-and-swap, tudo em CDK Python.
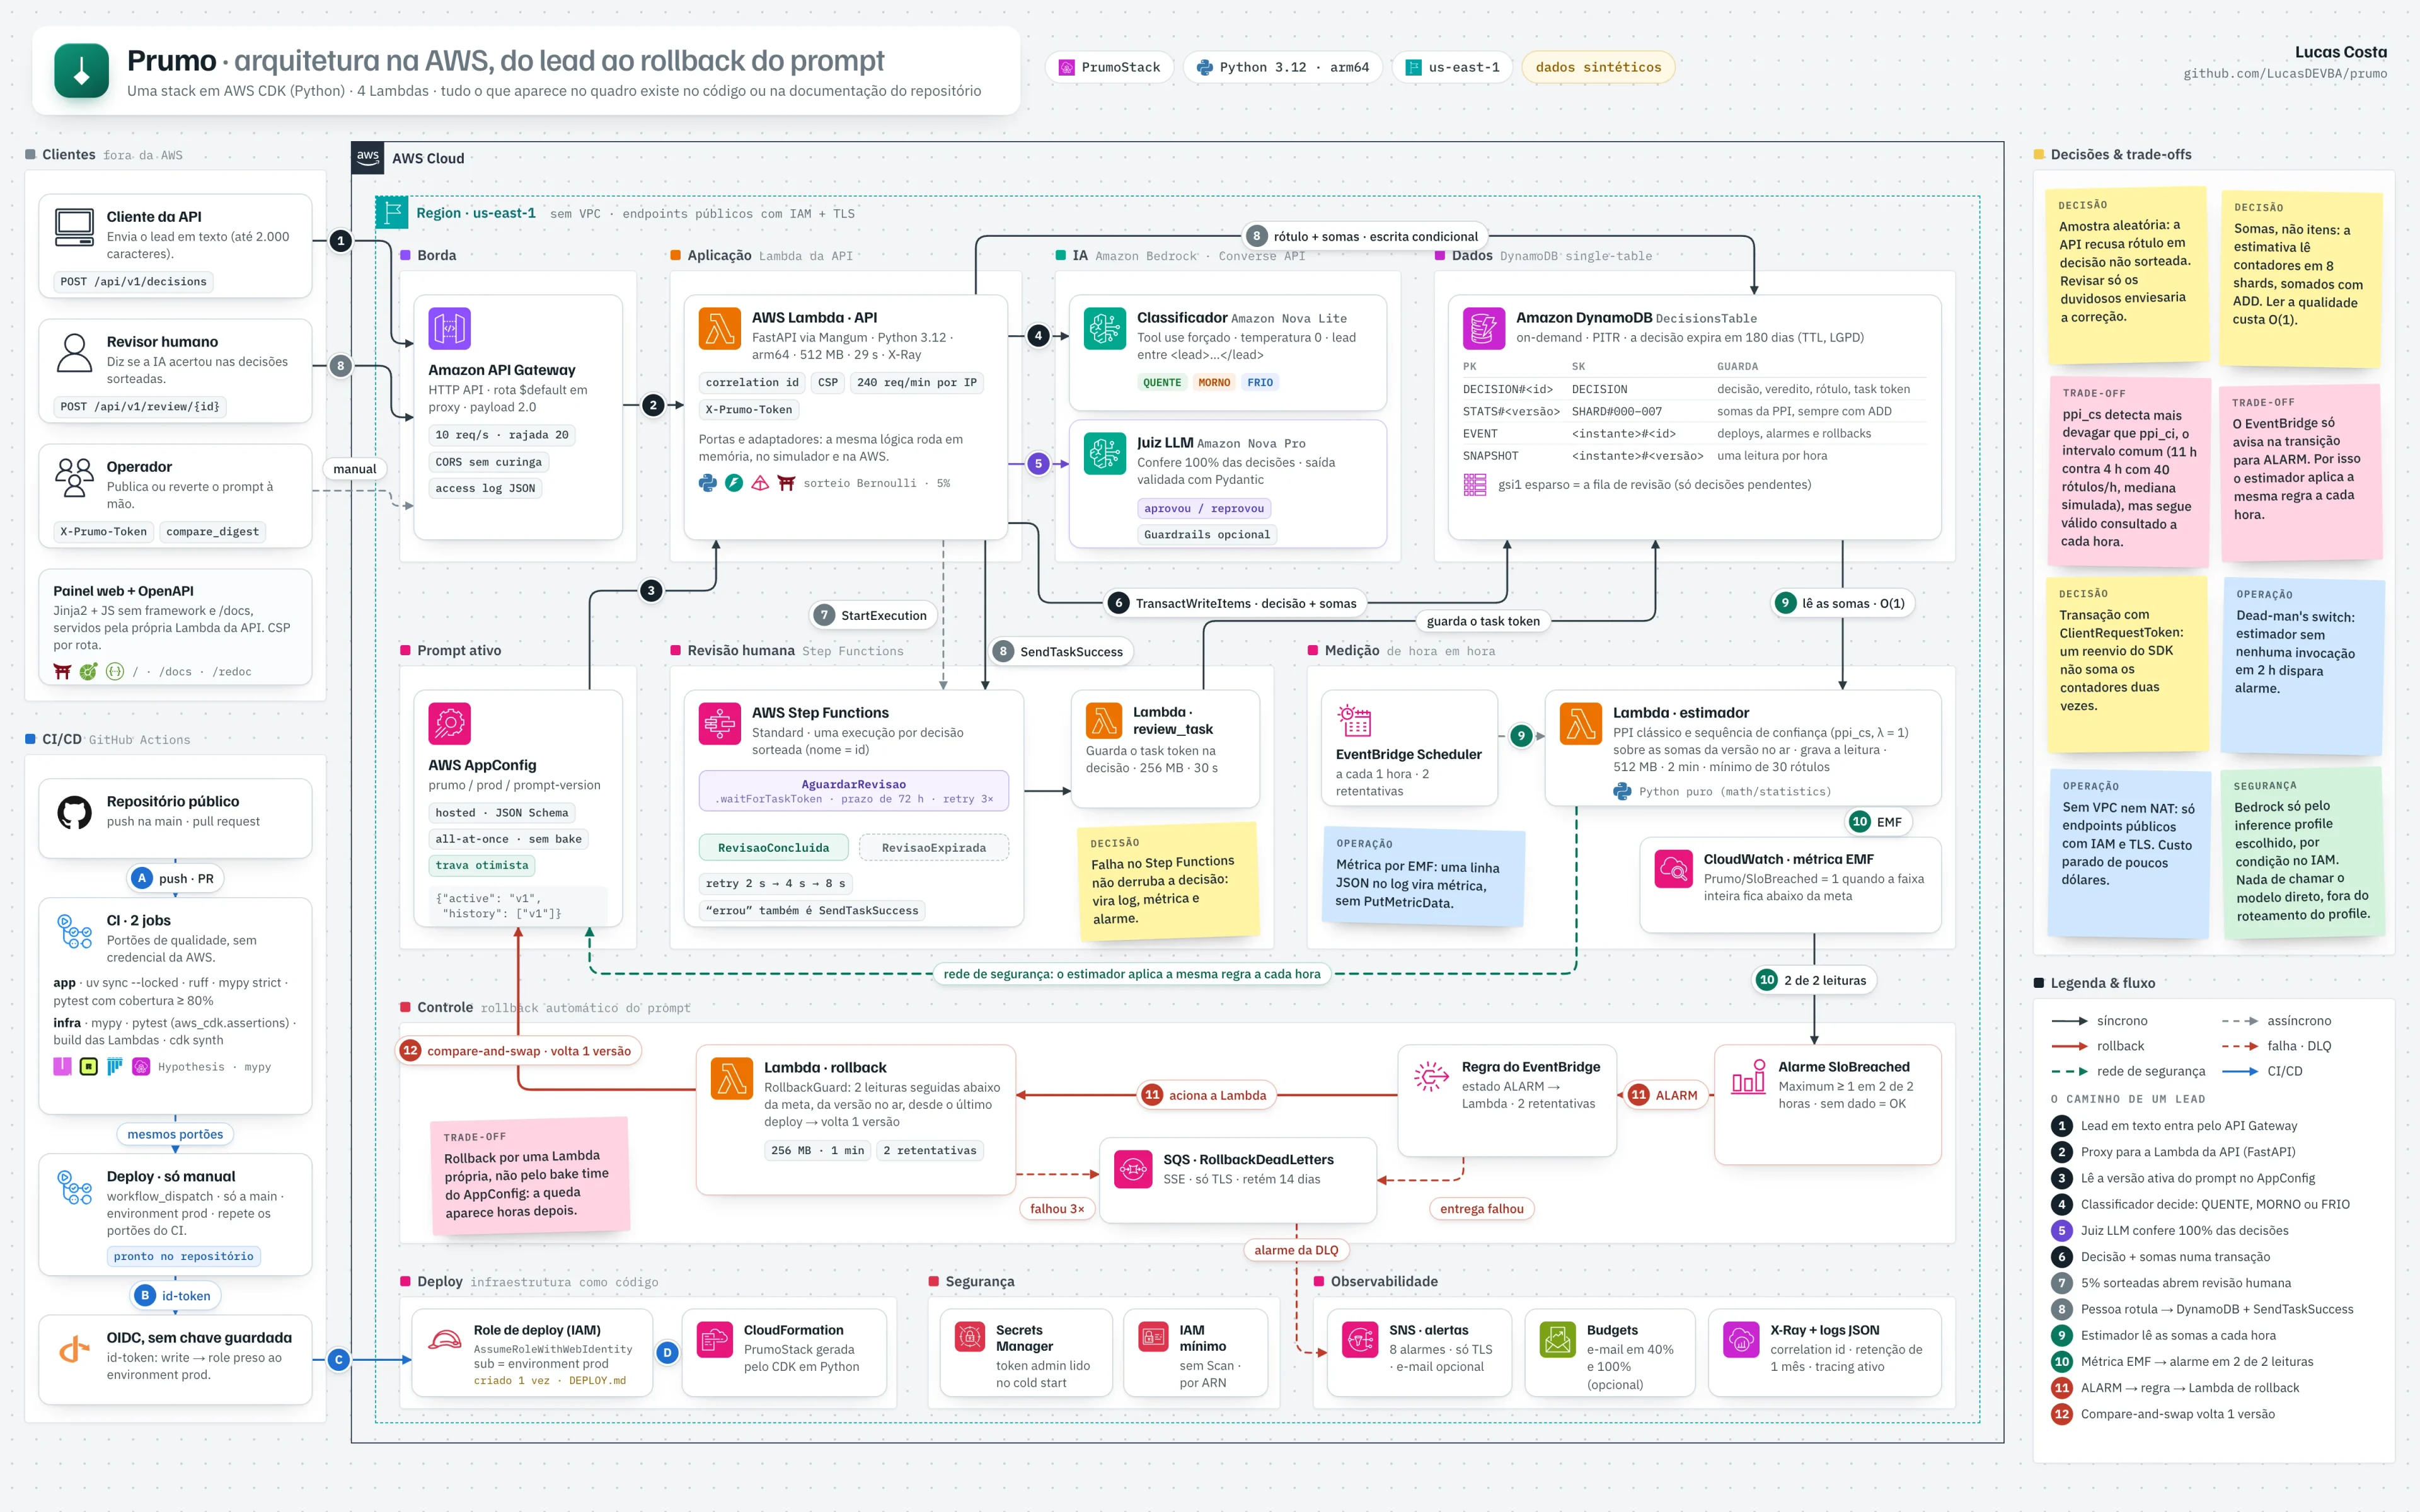
    Quadro de arquitetura do Prumo no estilo de um board do Miro, na AWS, do lead ao rollback do prompt: uma stack em AWS CDK (Python) com 4 Lambdas, dentro dos grupos AWS Cloud e Region us-east-1, sem VPC e com endpoints públicos com IAM e TLS. Fora da AWS ficam o cliente da API, o revisor humano, o operador e o painel web com OpenAPI. O caminho do lead, numerado de 1 a 12, entra pelo API Gateway (HTTP API com limite de requisições) até a Lambda da API em FastAPI via Mangum, que lê a versão ativa do prompt no AppConfig, classifica o lead com a Nova Lite no Bedrock em QUENTE, MORNO ou FRIO, manda o juiz LLM, a Nova Pro, conferir 100% das decisões e grava decisão e somas numa transação no DynamoDB; 5% das decisões, sorteadas, abrem a revisão humana no Step Functions com waitForTaskToken e prazo de 72 h, e a pessoa rotula pela API. De hora em hora, o EventBridge Scheduler aciona a Lambda do estimador, que lê as somas, calcula a sequência de confiança e publica a métrica EMF no CloudWatch; o alarme SloBreached dispara em 2 de 2 leituras, uma regra do EventBridge aciona a Lambda de rollback e o compare-and-swap no AppConfig volta uma versão, com DLQ no SQS e alerta por SNS na falha, e o estimador aplica a mesma regra a cada hora como rede de segurança. A entrega vai de A a D: push no repositório público, CI com 2 jobs, deploy manual por OIDC sem chave guardada e CloudFormation gerado pelo CDK. Completam o quadro as faixas de segurança (Secrets Manager e IAM mínimo) e de observabilidade (SNS, Budgets, X-Ray e logs JSON), as notas adesivas com decisões e trade-offs e a legenda com os 12 passos do lead.
    Quadro de arquitetura do Prumo no estilo de um board do Miro, na AWS, do lead ao rollback do prompt: uma stack em AWS CDK (Python) com 4 Lambdas, dentro dos grupos AWS Cloud e Region us-east-1, sem VPC e com endpoints públicos com IAM e TLS. Fora da AWS ficam o cliente da API, o revisor humano, o operador e o painel web com OpenAPI. O caminho do lead, numerado de 1 a 12, entra pelo API Gateway (HTTP API com limite de requisições) até a Lambda da API em FastAPI via Mangum, que lê a versão ativa do prompt no AppConfig, classifica o lead com a Nova Lite no Bedrock em QUENTE, MORNO ou FRIO, manda o juiz LLM, a Nova Pro, conferir 100% das decisões e grava decisão e somas numa transação no DynamoDB; 5% das decisões, sorteadas, abrem a revisão humana no Step Functions com waitForTaskToken e prazo de 72 h, e a pessoa rotula pela API. De hora em hora, o EventBridge Scheduler aciona a Lambda do estimador, que lê as somas, calcula a sequência de confiança e publica a métrica EMF no CloudWatch; o alarme SloBreached dispara em 2 de 2 leituras, uma regra do EventBridge aciona a Lambda de rollback e o compare-and-swap no AppConfig volta uma versão, com DLQ no SQS e alerta por SNS na falha, e o estimador aplica a mesma regra a cada hora como rede de segurança. A entrega vai de A a D: push no repositório público, CI com 2 jobs, deploy manual por OIDC sem chave guardada e CloudFormation gerado pelo CDK. Completam o quadro as faixas de segurança (Secrets Manager e IAM mínimo) e de observabilidade (SNS, Budgets, X-Ray e logs JSON), as notas adesivas com decisões e trade-offs e a legenda com os 12 passos do lead.
  9. API documentada

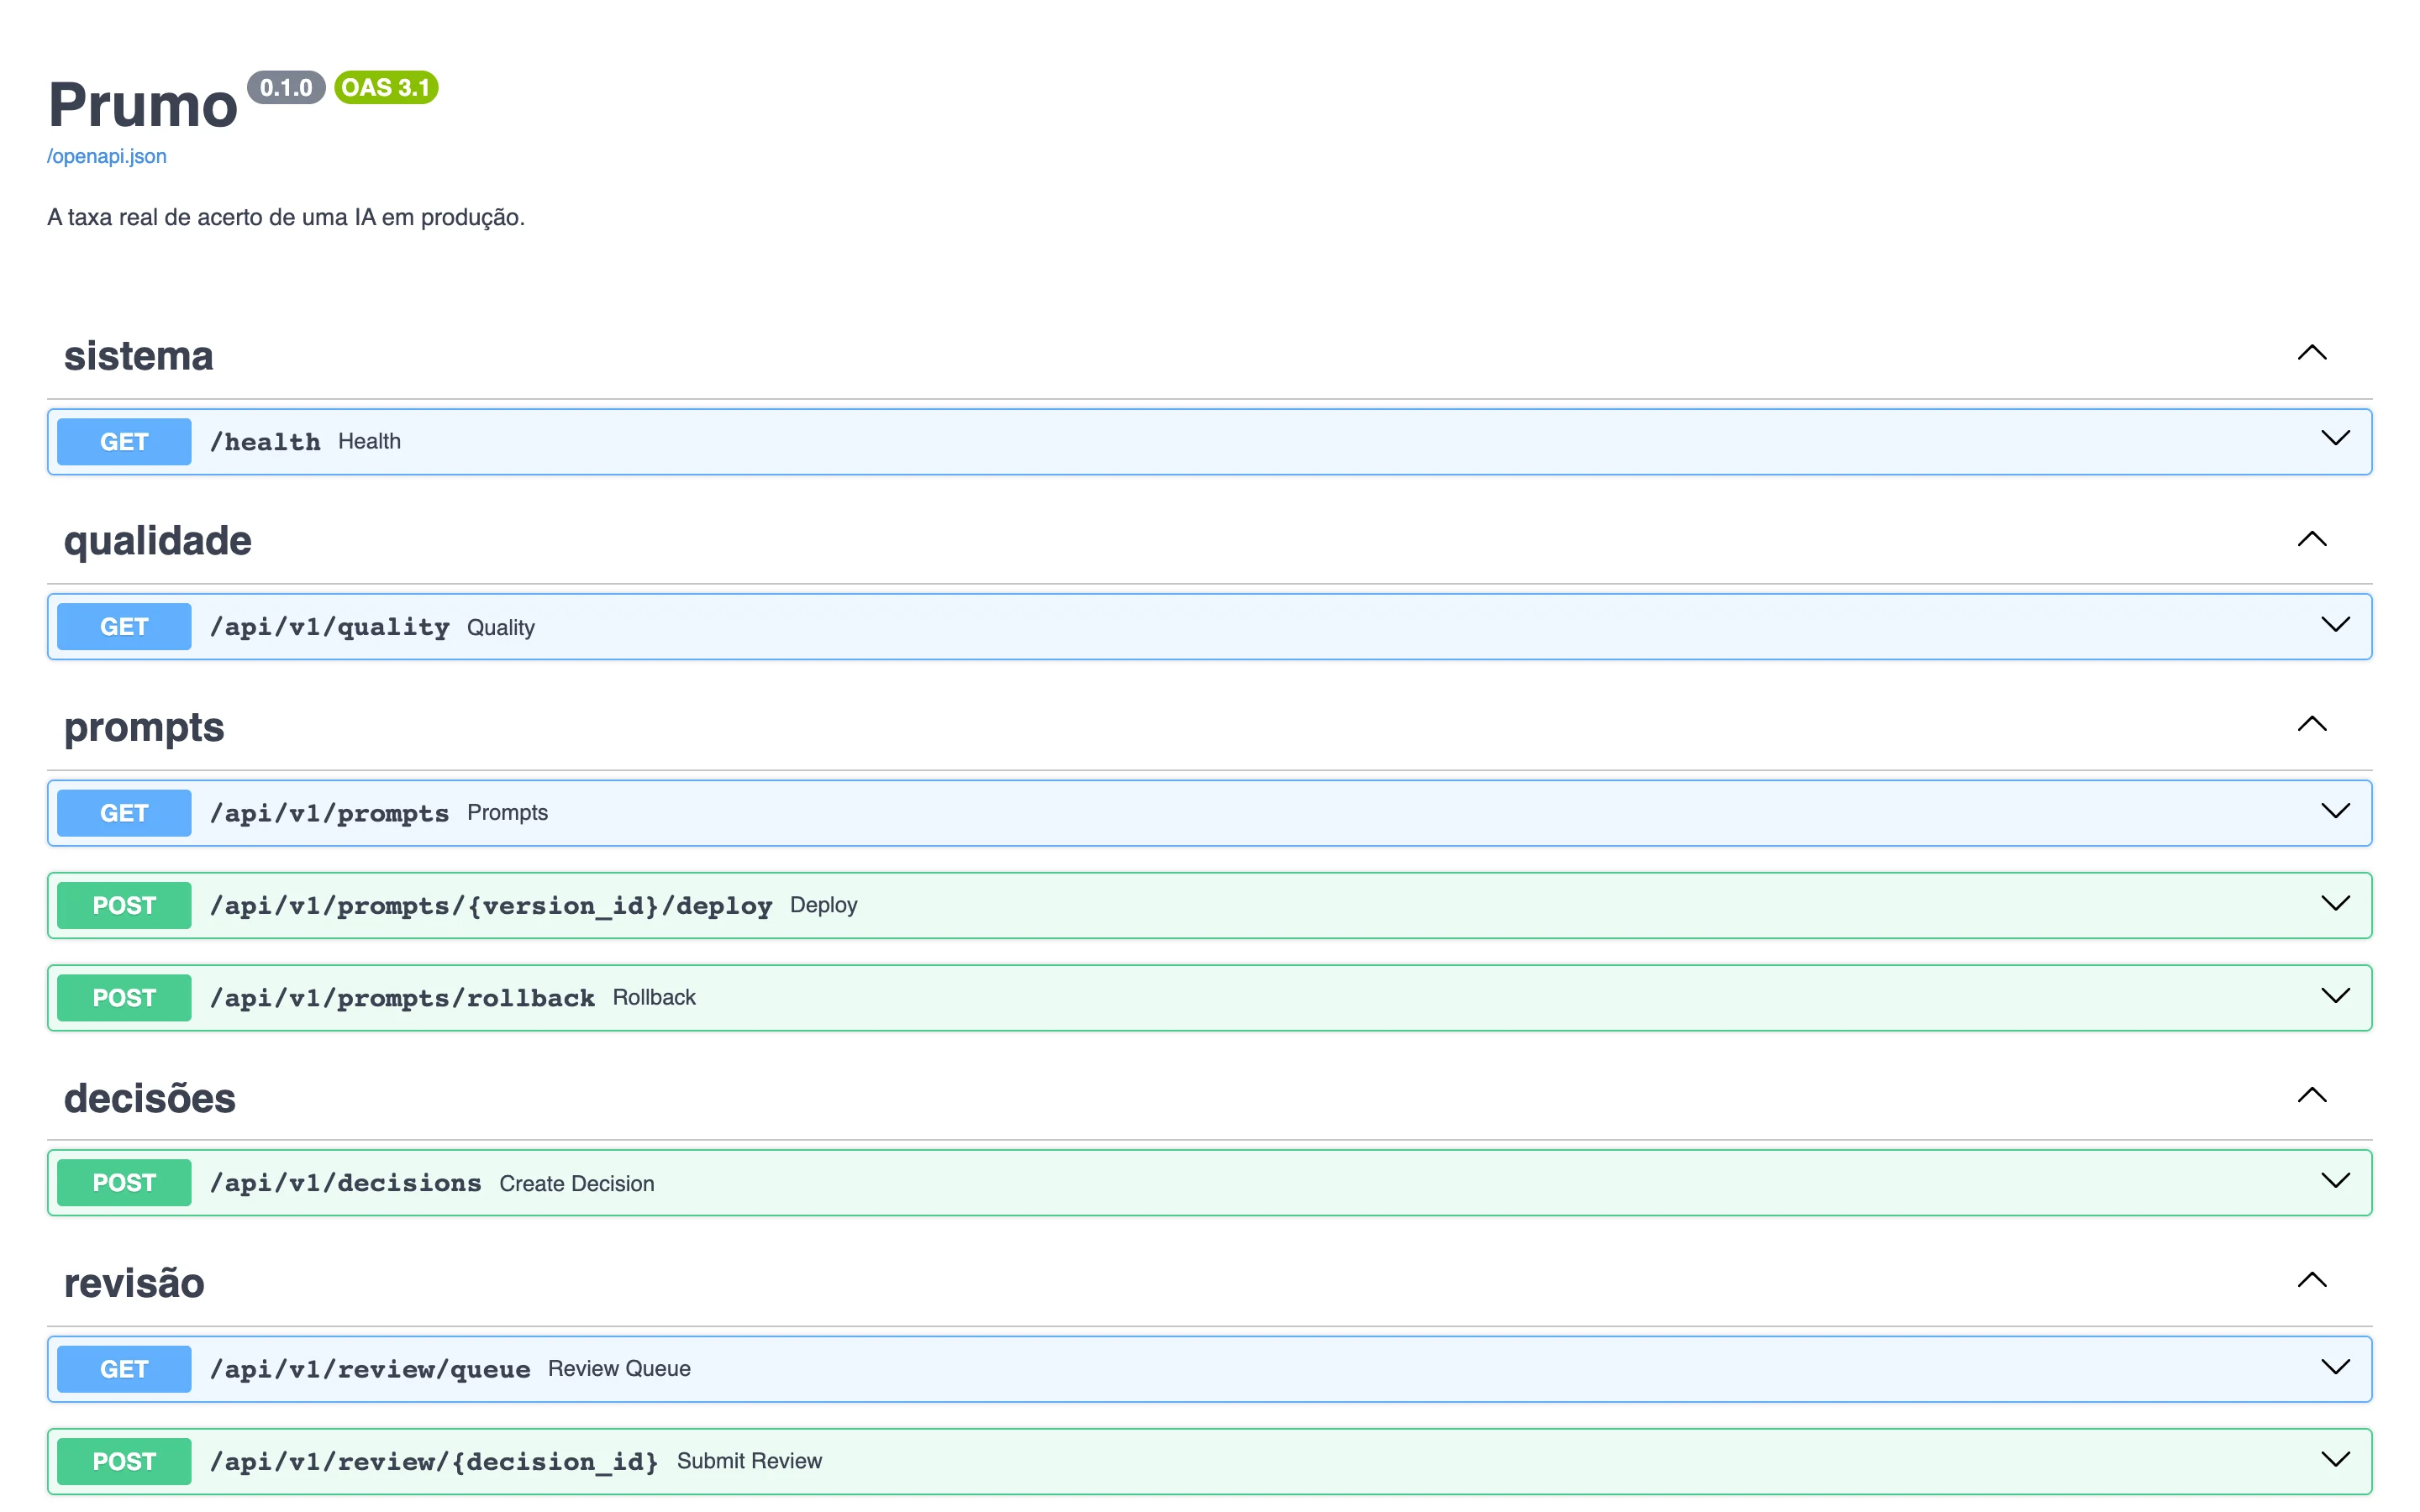
    A API em FastAPI documenta com OpenAPI as rotas de qualidade, prompts, decisões e revisão humana, inclusive deploy e rollback do prompt.

    Documentação OpenAPI do Prumo gerada pelo FastAPI em /docs: versão 0.1.0, OAS 3.1, o resumo A taxa real de acerto de uma IA em produção e as rotas agrupadas por tag: sistema (GET /health), qualidade (GET /api/v1/quality), prompts (GET /api/v1/prompts, POST /api/v1/prompts/{version_id}/deploy e POST /api/v1/prompts/rollback), decisões (POST /api/v1/decisions) e revisão (GET /api/v1/review/queue e POST /api/v1/review/{decision_id}).
    Documentação OpenAPI do Prumo gerada pelo FastAPI em /docs: versão 0.1.0, OAS 3.1, o resumo A taxa real de acerto de uma IA em produção e as rotas agrupadas por tag: sistema (GET /health), qualidade (GET /api/v1/quality), prompts (GET /api/v1/prompts, POST /api/v1/prompts/{version_id}/deploy e POST /api/v1/prompts/rollback), decisões (POST /api/v1/decisions) e revisão (GET /api/v1/review/queue e POST /api/v1/review/{decision_id}).
  10. Resultados

    O benchmark roda 10 simulações por linha, e o teste real na AWS usou 30 leads sintéticos: a IA acertou 60%, e o juiz aprovou 70%.
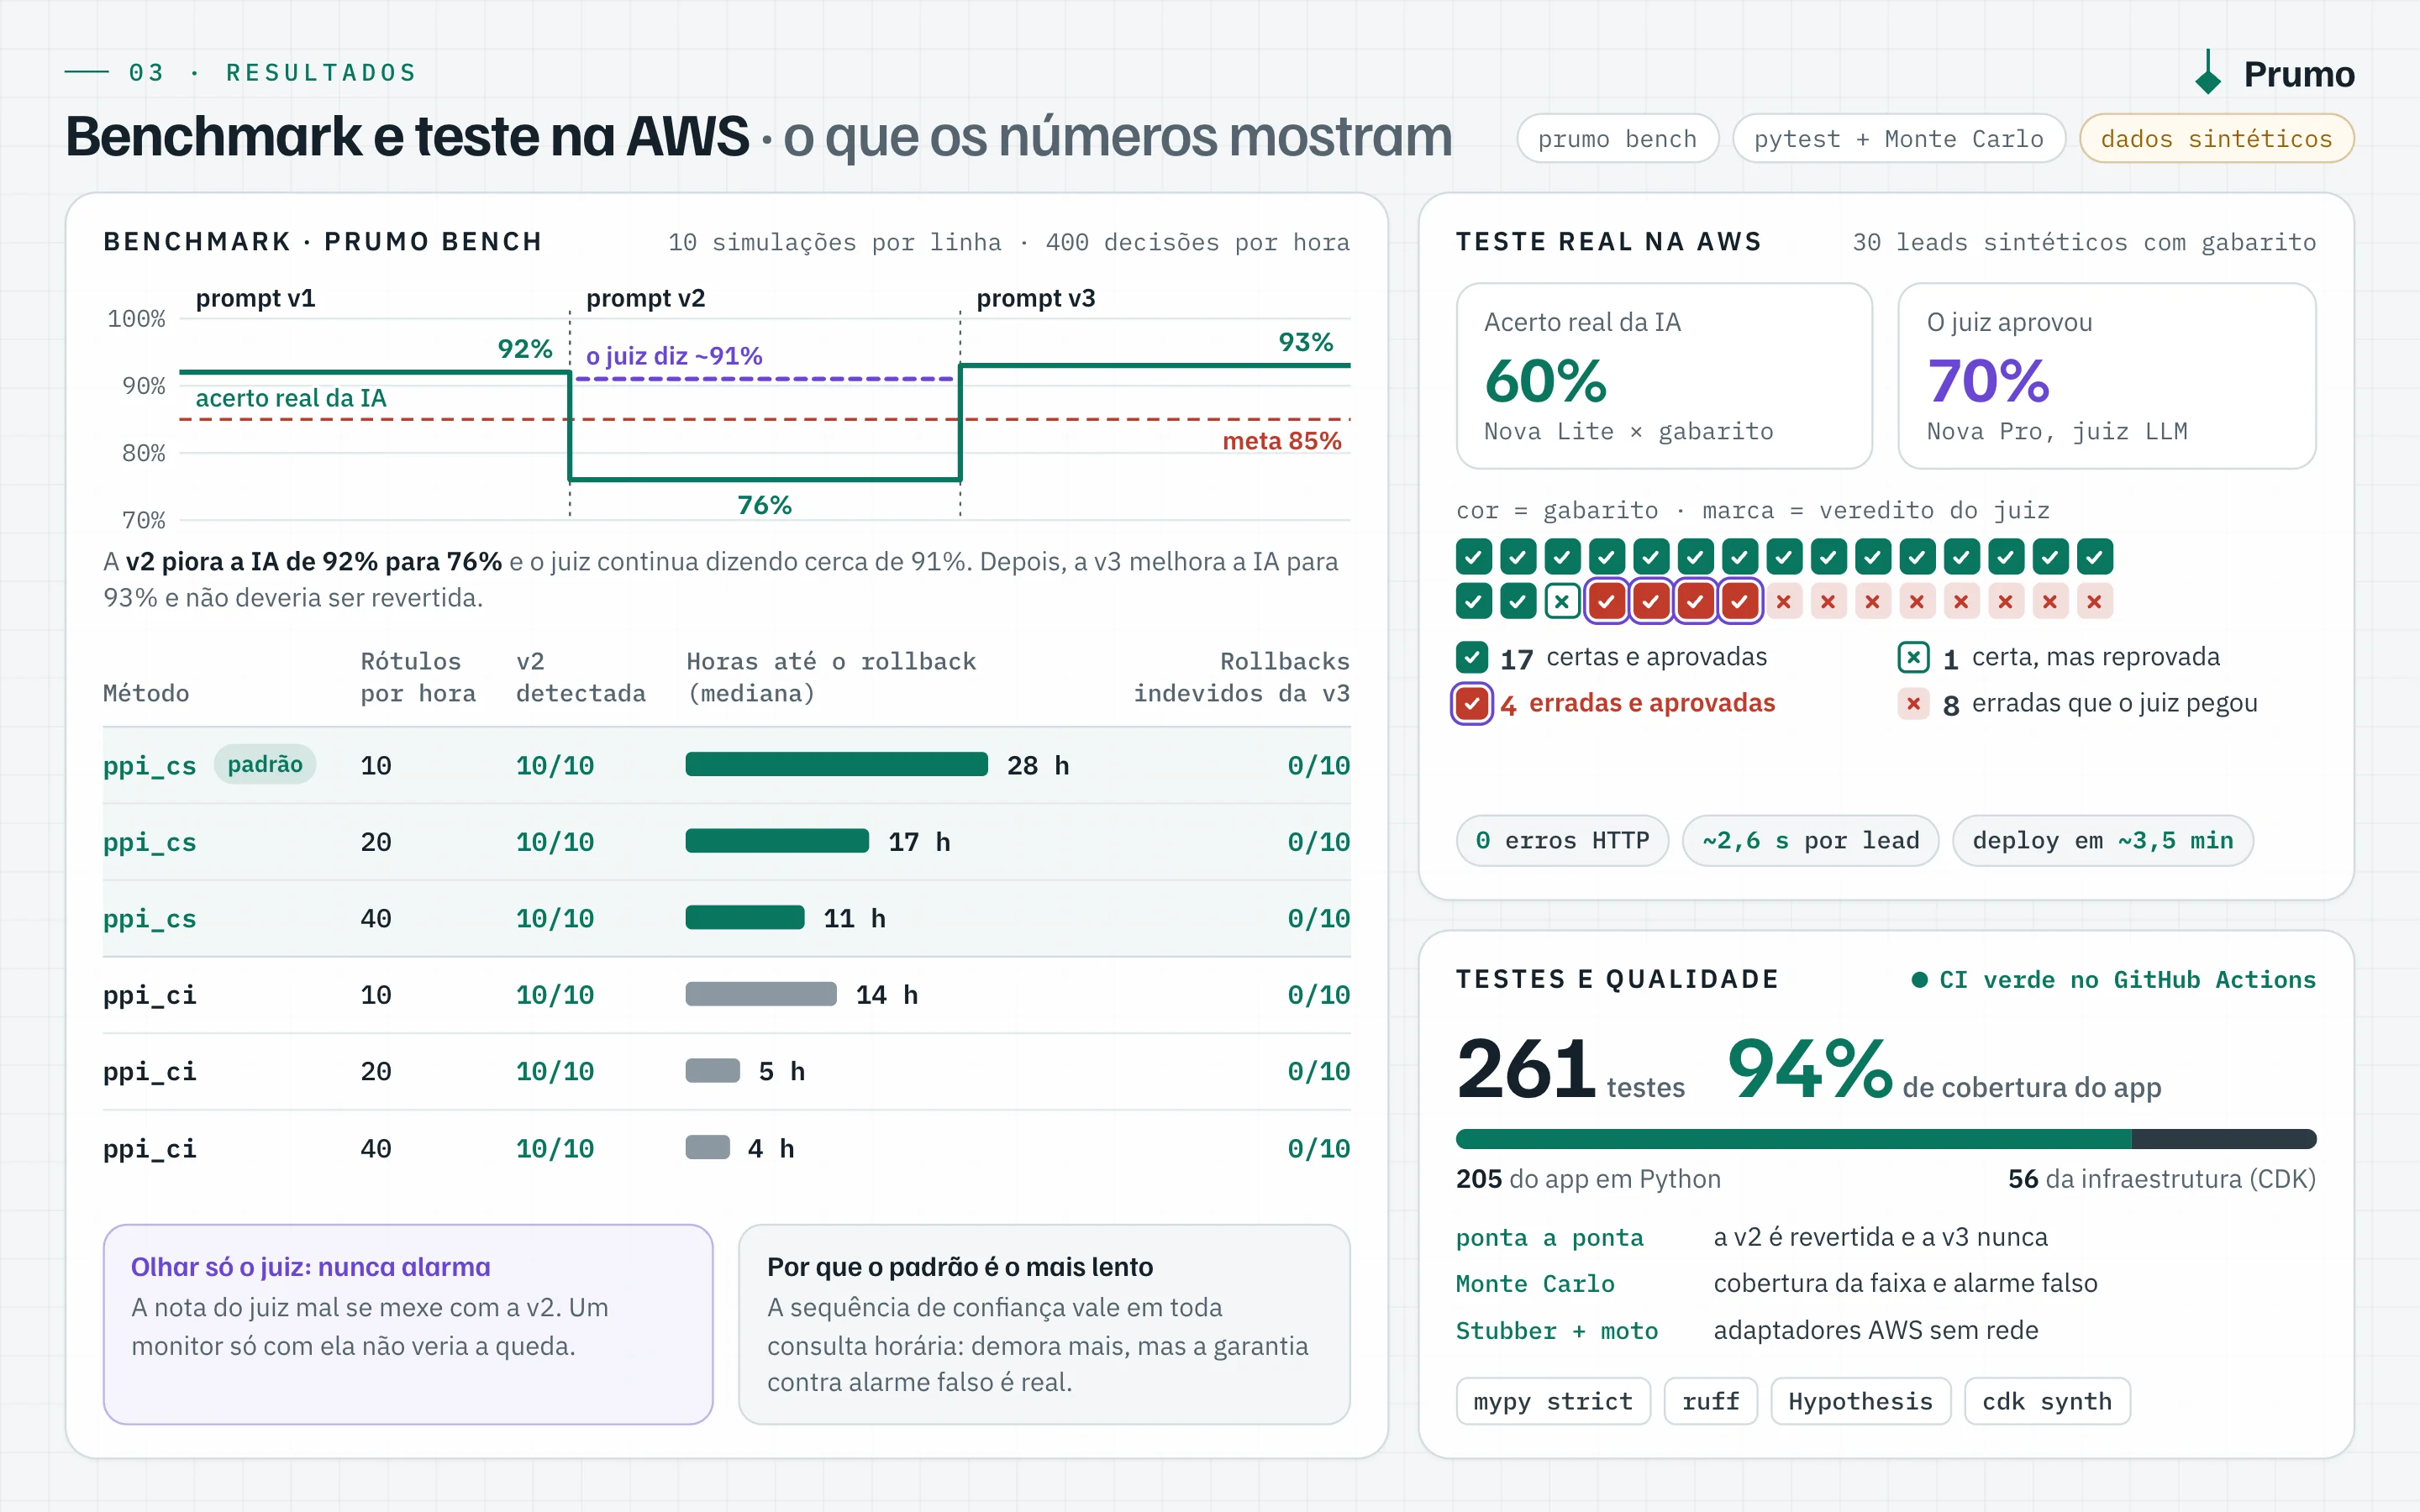
    Prancha de resultados, com dados sintéticos. À esquerda, o benchmark prumo bench, com 10 simulações por linha e 400 decisões por hora: um gráfico mostra a v2 derrubando o acerto real da IA de 92% para 76% enquanto o juiz segue dizendo cerca de 91%, e a v3 subindo para 93%, com a meta de 85%; a tabela traz, para ppi_cs, o padrão, com 10, 20 e 40 rótulos por hora, a v2 detectada 10 de 10 vezes, rollback em 28, 17 e 11 horas (mediana) e 0 de 10 rollbacks indevidos da v3; para ppi_ci, 14, 5 e 4 horas, também com 0 de 10; e duas notas: olhar só o juiz nunca alarma, e o padrão é o mais lento porque a sequência de confiança vale em toda consulta horária. À direita, o teste real na AWS com 30 leads sintéticos com gabarito: 60% de acerto real da Nova Lite contra 70% aprovados pelo juiz Nova Pro, numa grade com 17 certas e aprovadas, 4 erradas e aprovadas, 1 certa mas reprovada e 8 erradas que o juiz pegou, mais 0 erros HTTP, cerca de 2,6 s por lead e deploy em cerca de 3,5 min. Abaixo, o quadro de testes e qualidade: CI verde no GitHub Actions, testes do app em Python e da infraestrutura em CDK, cobertura do app, testes ponta a ponta, Monte Carlo, Stubber e moto, mypy strict, ruff, Hypothesis e cdk synth.
    Prancha de resultados, com dados sintéticos. À esquerda, o benchmark prumo bench, com 10 simulações por linha e 400 decisões por hora: um gráfico mostra a v2 derrubando o acerto real da IA de 92% para 76% enquanto o juiz segue dizendo cerca de 91%, e a v3 subindo para 93%, com a meta de 85%; a tabela traz, para ppi_cs, o padrão, com 10, 20 e 40 rótulos por hora, a v2 detectada 10 de 10 vezes, rollback em 28, 17 e 11 horas (mediana) e 0 de 10 rollbacks indevidos da v3; para ppi_ci, 14, 5 e 4 horas, também com 0 de 10; e duas notas: olhar só o juiz nunca alarma, e o padrão é o mais lento porque a sequência de confiança vale em toda consulta horária. À direita, o teste real na AWS com 30 leads sintéticos com gabarito: 60% de acerto real da Nova Lite contra 70% aprovados pelo juiz Nova Pro, numa grade com 17 certas e aprovadas, 4 erradas e aprovadas, 1 certa mas reprovada e 8 erradas que o juiz pegou, mais 0 erros HTTP, cerca de 2,6 s por lead e deploy em cerca de 3,5 min. Abaixo, o quadro de testes e qualidade: CI verde no GitHub Actions, testes do app em Python e da infraestrutura em CDK, cobertura do app, testes ponta a ponta, Monte Carlo, Stubber e moto, mypy strict, ruff, Hypothesis e cdk synth.

Funcionalidades e as dores que resolvem

Cada funcionalidade nasceu de um problema real da operação.

  1. 01

    Taxa real com faixa de confiança

    Dor
    O juiz LLM confere 100% das decisões, mas erra sempre para o mesmo lado: a nota dele não é a taxa real de acerto, e revisar tudo à mão não escala.
    Solução
    Uma amostra aleatória rotulada por pessoas mede o erro do juiz, e a Prediction-Powered Inference (PPI e PPI++) desconta esse erro da nota dele, entregando a taxa real com faixa de confiança. A estimativa usa só somas e somas de quadrados, então ler a qualidade custa O(1).

    Impacto: O intervalo de 95% contém a verdade entre 92% e 98% das vezes (400 simulações de Monte Carlo)

  2. 02

    Sequência de confiança

    Dor
    Um intervalo de confiança comum vale para uma consulta; lido a cada hora, a chance de alarme falso cresce a cada leitura.
    Solução
    O método padrão (ppi_cs) usa uma sequência de confiança assintótica (Waudby-Smith et al., 2024), que continua válida mesmo consultada para sempre, e exige ao menos 30 rótulos antes de qualquer decisão. Detecta mais devagar que o intervalo comum, em troca de uma garantia real contra alarme falso.

    Impacto: Consultada a cada hora por 30 horas, erra no máximo α + 2%

  3. 03

    Rollback automático do prompt

    Dor
    Uma versão de prompt que piora a IA não gera exceção nem alerta: sem medição, a regressão fica no ar até alguém notar.
    Solução
    Se a faixa inteira fica abaixo da meta (SLO de 85%) em 2 leituras seguidas, o alarme do CloudWatch aciona, pelo EventBridge, uma Lambda que volta o prompt para a versão anterior no AppConfig, sem novo deploy de código.

    Impacto: Rollback em 28, 17 e 11 h (mediana) com 10, 20 e 40 rótulos por hora; v2 detectada 10/10

  4. 04

    Dois gatilhos, uma troca atômica

    Dor
    O EventBridge só avisa na transição para ALARM: se essa tentativa falha, o alarme fica parado sem gerar evento novo, e um alarme reentregue poderia voltar duas versões.
    Solução
    O estimador horário aplica a mesma regra como rede de segurança, e a troca é compare-and-swap sobre a versão medida: alarme reentregue, clique manual simultâneo ou os dois gatilhos juntos nunca voltam duas versões. Evento que falha vai para uma fila SQS de mensagens mortas, com alarme.

    Impacto: 0/10 rollbacks indevidos da v3 em todas as configurações do benchmark

  5. 05

    Revisão humana no Step Functions

    Dor
    Se só os casos duvidosos forem revisados, a correção do viés do juiz fica enviesada, e um rótulo gravado duas vezes contaria em dobro na estimativa.
    Solução
    As decisões sorteadas entram numa máquina do Step Functions que espera o revisor com waitForTaskToken, por até 72 h. A API recusa rótulo em decisão que não foi sorteada, e a gravação no DynamoDB é condicional, o que impede rotular a mesma decisão duas vezes.
  6. 06

    Classificação com Bedrock

    Dor
    Pedir JSON ao modelo e torcer pelo formato quebra o fluxo na primeira resposta fora do padrão, e o texto do lead pode trazer instruções injetadas.
    Solução
    Classificador e juiz chamam o Bedrock pela Converse API com a ferramenta forçada (tool use) e temperatura 0, e a saída ainda é validada com Pydantic. O prompt manda ignorar instruções dentro do lead, e o Bedrock Guardrails pode ser ligado por configuração.

    Impacto: Teste real com 30 leads sintéticos: 0 erros HTTP e cerca de 2,6 s por lead

  7. 07

    Painel e simulador

    Dor
    Uma queda silenciosa de qualidade é difícil de explicar sem ver o juiz e a taxa real lado a lado, e testar a ideia direto na AWS custa dinheiro.
    Solução
    O painel mostra a nota do juiz, a taxa real estimada com a faixa, a taxa de queima do orçamento de erro e os eventos. No modo simulado, sem AWS e sem custo, dá para publicar a v2, mudar os rótulos por hora, ligar ou desligar o rollback e rotular decisões.

    Impacto: A mesma lógica roda no simulador e na AWS, por portas e adaptadores

  8. 08

    Benchmark de métodos

    Dor
    Sem comparar métodos, não dá para saber quantos rótulos por hora bastam nem quanto custa, em horas, cada garantia estatística.
    Solução
    O comando prumo bench roda 10 simulações por linha: a v1 no ar, a v2 que derruba a IA de 92% para 76% e a v3 que a melhora para 93%, medindo detecção, horas até o rollback e rollbacks indevidos para ppi_cs e ppi_ci com 10, 20 e 40 rótulos por hora.

    Impacto: ppi_ci reverte em 14, 5 e 4 h; um monitor só do juiz nunca alarma

  9. 09

    Infraestrutura como código

    Dor
    Montar Lambda, Step Functions, alarmes e AppConfig à mão no console não se reproduz, e chave de acesso guardada no CI é risco de vazamento.
    Solução
    Uma única stack em AWS CDK (Python) cria todos os recursos da aplicação, com testes que travam as invariantes do template. O GitHub Actions repete lint, tipos e testes antes de assumir, por OIDC, um role preso ao environment de produção, e o deploy só sai com disparo manual.

    Impacto: Deploy da stack em cerca de 3,5 min

  10. 10

    Dados pessoais e segredos

    Dor
    O texto do lead é dado pessoal (LGPD), e um token em variável de ambiente fica visível para quem lê a configuração da Lambda.
    Solução
    O texto da decisão expira em 180 dias pelo TTL do DynamoDB, enquanto as somas da estimativa ficam. O token administrativo é gerado pelo Secrets Manager e lido no cold start; sem ele, as rotas protegidas recusam o pedido.

    Impacto: Nenhum dado de cliente: todos os leads são sintéticos